Num problema supervisionado, a avaliação tem gabarito. Aqui não tem. Por isso a comparação precisa ser desenhada para ser difícil de ganhar: contra o cadastro, contra o acaso, com o mesmo número de grupos e em métricas que o modelo nunca viu.
A métrica: quanto da variação o grupo explica
O η² mede a parcela da variação de uma métrica que é explicada pelo grupo da loja — a variação entre as médias dos grupos dividida pela variação total. Se o grupo diz muito sobre como a loja vende, o η² é alto. Quatro segmentações, dez métricas:
| Métrica (η², %) | Origem | tipo_loja | sortimento | Cluster | Aleatório |
|---|---|---|---|---|---|
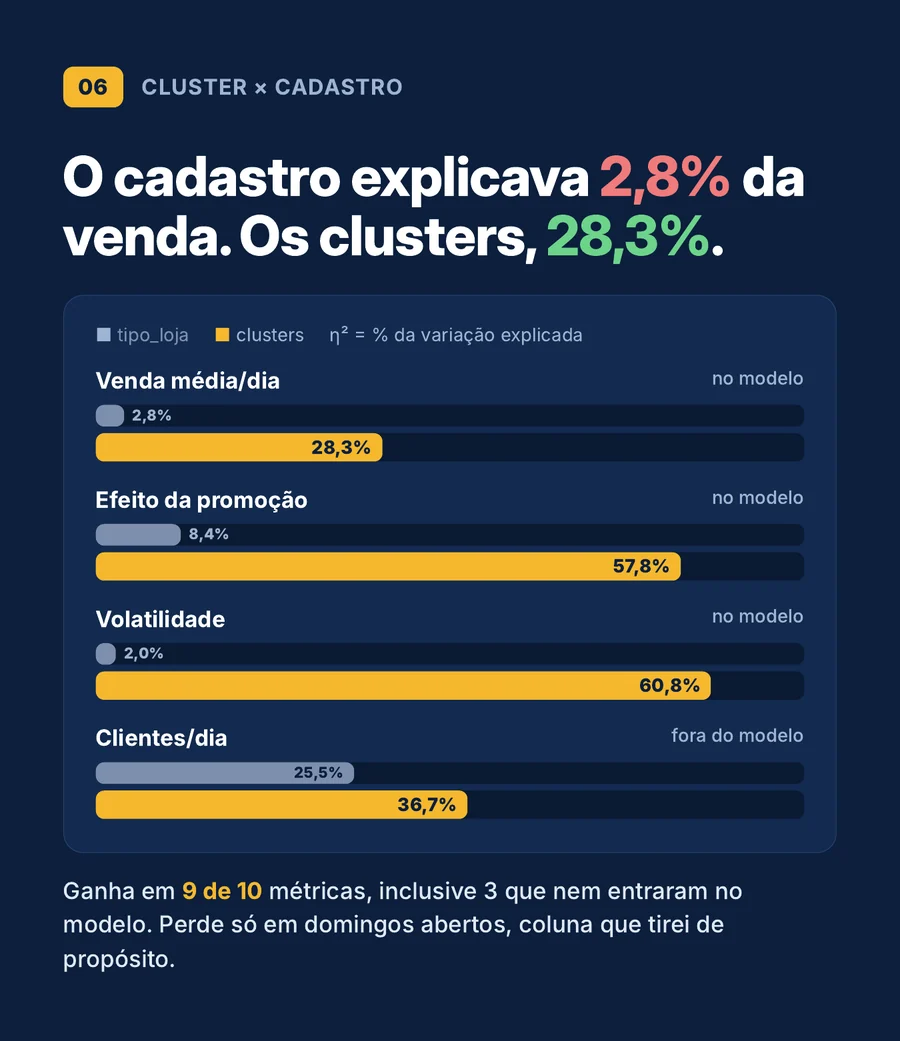
| Venda média/dia | no modelo | 2,8 | 2,5 | 28,3 | 0,3 |
| Ticket médio | no modelo | 42,3 | 11,1 | 50,6 | 0,4 |
| Efeito da promoção | no modelo | 8,4 | 9,3 | 57,8 | 0,4 |
| Volatilidade | no modelo | 2,0 | 1,5 | 60,8 | 0,4 |
| Sazonalidade | no modelo | 3,1 | 10,1 | 43,2 | 0,3 |
| Distância ao concorrente | no modelo | 2,5 | 2,4 | 20,7 | 0,3 |
| Clientes/dia | fora | 25,5 | 10,9 | 36,7 | 0,4 |
| Pico de sábado | fora | 22,4 | 5,4 | 43,4 | 0,4 |
| Efeito da promoção (dias úteis) | fora | 6,0 | 6,9 | 29,0 | 0,3 |
| Proporção de domingos abertos | fora | 70,0 | 37,4 | 6,6 | 0,4 |
Por que a comparação é justa
- Ganha em 9 de 10 métricas — inclusive em 3 que ficaram fora do modelo (clientes, pico de sábado e efeito da promoção em dias úteis). Ganhar só nas próprias features seria quase tautológico; ganhar fora delas é sinal de que os grupos capturam algo real.
- Não é efeito do número de grupos. Uma partição aleatória com os mesmos tamanhos explica de 0,3% a 0,4%. E o K-Means com k = 4 — o mesmo número de categorias do tipo de loja — também ganha em 9 de 10.
- Os pares ficam mais parecidos. O coeficiente de variação da venda dentro dos grupos é de 0,284, contra 0,351 dentro do tipo de loja e 0,344 na rede inteira. É essa dispersão menor que torna a mediana do grupo uma referência defensável.
A única derrota está documentada: domingos abertos (6,6% contra 70,0%). É a coluna que eu tirei do modelo de propósito, por ter 97% de zeros. Mesmo assim, 26 das 33 lojas que abrem domingo caíram em dois grupos (Sazonal e Alto fluxo) — o comportamento de domingo aparece pelas outras variáveis.
Estável de verdade
A regra da parte 2: ARI médio ≥ 0,80. O ARI mede o quanto duas partições concordam, descontado o acaso — 1 é idêntico, 0 é aleatório.
| Teste (30 execuções) | ARI médio | ARI mínimo | Abaixo de 0,80 | Lojas que trocam (média) | Pior caso |
|---|---|---|---|---|---|
| Troca de semente | 0,992 | 0,978 | 0 | 0,4% | 1,0% |
| Reordenação das linhas | 0,990 | 0,968 | 0 | 0,5% | 1,6% |
| Subamostra de 80% das lojas | 0,888 | 0,690 | 5 | 5,4% | 20,6% |
Os três testes passam. Com 100 subamostras, o ARI médio fica em 0,898. Mas a média esconde a pergunta que o gerente vai fazer: "e a minha loja?". Por isso medi a permanência loja a loja:
| Permanência no mesmo grupo (100 subamostras) | Lojas | % |
|---|---|---|
| Acima de 95% | 861 | 77,2 |
| 80% a 95% | 130 | 11,7 |
| 50% a 80% | 119 | 10,7 |
| Até 50% | 5 | 0,4 |
As instáveis não são aleatórias: são as de fronteira. A silhueta média das lojas que ficam no grupo menos de 80% das vezes é 0,033; das que ficam mais de 95%, 0,245 (Spearman de 0,683 entre as duas medidas). Essas lojas não foram escondidas — foram marcadas no plano de metas para revisão com o gestor, como mostra a parte 8.
Acionável: nenhum par leva à mesma decisão
O último teste não tem métrica. Para cada grupo, uma linha de decisão em Comercial, Trade e Supply; se duas linhas forem iguais, os grupos se fundem. Nenhum par repetiu. O par mais próximo (0 e 1, distância de 2,22 entre centroides) se separa por 1,43 desvio de ticket e pela distância ao concorrente — e leva a estratégias opostas: aumentar a cesta num caso, ganhar fluxo no outro. A matriz completa está na próxima parte, junto com os reais.
Parte 6 de 9 da série 1.115 lojas, 1 régua injusta. O mapa completo da série reúne todas as partes, os cinco grupos e os números finais. O código, os notebooks e a documentação estão no repositório no GitHub ↗.