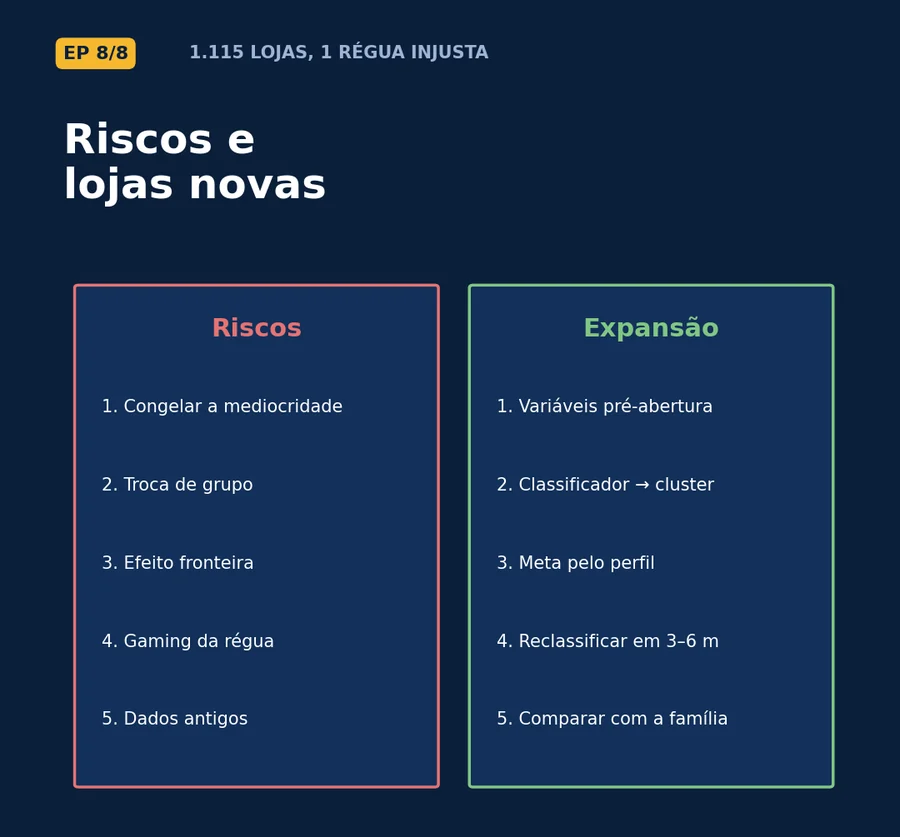
Todo modelo que define a meta de alguém precisa responder antes: o que pode dar errado? Esta parte junta os riscos de usar clusters para meta e a segunda entrega do projeto — enquadrar uma loja que ainda não tem com quem se comparar.
Seis riscos, e onde cada um ficou
| Risco | O que pode acontecer | Como ficou |
|---|---|---|
| Congelar a mediocridade | Se o grupo inteiro performa mal, a referência dos pares também é baixa | A meta é calibrada para a rede fechar +5%, e toda loja recebe ao menos a meta de manutenção (2,44%) |
| Efeito fronteira | Lojas no limite entre dois grupos recebem referências diferentes por pouca diferença real | 122 lojas de baixa permanência marcadas no plano; alerta automático de fronteira para lojas novas |
| Troca de grupo | Reforma ou concorrente novo mudam o perfil da loja | Classificação provisória até 24 meses; revisão periódica dos grupos recomendada |
| Subgrupo extremo | As 13 lojas do tipo b dentro do grupo 4 têm ticket de R$ 5,18 contra R$ 8,27 do resto | Marcadas como "subgrupo 7 dias" para revisão |
| Gaming | O gerente que entende a régua tenta "mudar de grupo" em vez de melhorar | Em aberto: depende de governança, não de modelo |
| Dados antigos | O histórico de 2013–2015 não captura mudanças recentes de mercado | Em aberto: exige retreino com dados atuais antes de uso real |
As marcações não mudam a meta calculada. Elas sinalizam onde a referência de pares é menos firme e a conversa com o gestor precisa acontecer antes do número ser comunicado.
Entrega 2: a loja nova entra no grupo sem retreinar nada
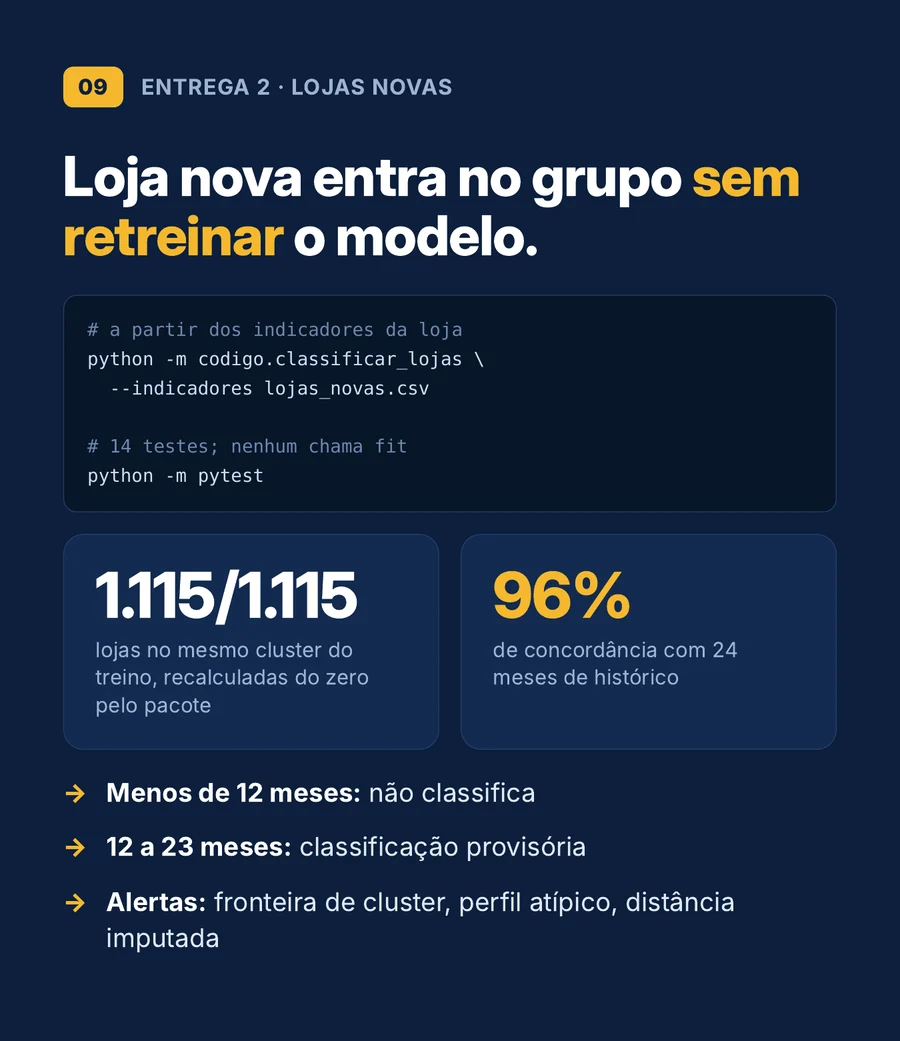
O pipeline treinado — log1p, o StandardScaler e o K-Means — foi salvo num artefato único junto com as regras de uso. Para uma loja nova, o pacote calcula os seis indicadores com as mesmas regras do treino e aplica só transform e predict. Nada é reajustado; um dos testes garante que nenhum fit é chamado.
# a partir dos indicadores já calculados
python -m codigo.classificar_lojas --indicadores lojas_novas.csv --saida classificacao.csv

# a partir do histórico diário + cadastro
python -m codigo.classificar_lojas --vendas vendas_novas.csv --cadastro cadastro_novas.csv

# 14 testes: reproduz os clusters do treino, nenhum fit, validação das entradas
python -m pytest
| Checagem de equivalência | Resultado |
|---|---|
| Indicadores recalculados do CSV bruto × base do treino | Maior diferença: 1,2 × 10⁻¹⁶ |
| Clusters das 1.115 lojas pelo pacote × treino | 1.115 de 1.115 iguais |
| Meta sugerida × coluna de meta do plano | Igual em todas as lojas |
| Hash dos 11 artefatos do treino antes e depois do deploy | Idênticos |
Teste você mesmo: o classificador de lojas roda este mesmo pipeline no navegador — uma loja pelo formulário ou uma base inteira por arquivo, inclusive o histórico diário bruto. Ele foi conferido contra o pacote em Python e devolve o mesmo grupo nas 1.115 lojas.
Quanto histórico uma loja precisa?
Essa regra não podia ser chute. Cada loja da base foi recortada para os primeiros N meses — e, separadamente, para os últimos N — como se fosse nova, e o grupo obtido foi comparado com o do histórico completo:
| Meses de histórico | Concordância (primeiros meses) | Concordância (últimos meses) | Pior grupo (últimos) |
|---|---|---|---|
| 3 | 83,2% | 73,7% | 12,3% |
| 6 | 36,3% | 80,4% | 16,9% |
| 12 | 86,7% | 88,0% | 41,5% |
| 18 | 87,3% | 91,0% | 53,8% |
| 24 | 96,6% | 96,1% | 64,6% |
Com menos de 12 meses, a sazonalidade não cobre um ano inteiro e algum grupo é praticamente sorteado. O mais sensível é o Sazonal: com os últimos 12 meses, só 41,5% das lojas dele voltam para o próprio grupo. Daí as regras exportadas:
| Regra | Valor |
|---|---|
| Não classifica | Menos de 12 meses de histórico |
| Classificação provisória | 12 a 23 meses |
| Classificação definitiva | 24 meses ou mais |
| Alerta de fronteira | Margem para o 2º grupo mais próximo abaixo de 10% (maior F1 contra as 122 lojas de baixa permanência) |
| Alerta de perfil atípico | Distância ao centroide acima do percentil 99 do grupo no treino |
| Meta sugerida | A mesma regra do plano de metas, sem recalibrar a rede |
O que mudou em relação ao plano inicial: no começo, a ideia era treinar um classificador separado para enquadrar lojas antes da abertura, com variáveis do ponto. Das seis features do modelo, porém, só a distância ao concorrente existe antes da loja abrir — as outras cinco são comportamento de venda. A entrega final enquadra a loja a partir de 12 meses de operação, com regra de confiança medida. Enquadrar uma loja que ainda não abriu segue como próximo passo, e exige variáveis de ponto que esta base não tem.
Parte 8 de 9 da série 1.115 lojas, 1 régua injusta. O mapa completo da série reúne todas as partes, os cinco grupos e os números finais. O código, os notebooks e a documentação estão no repositório no GitHub ↗.