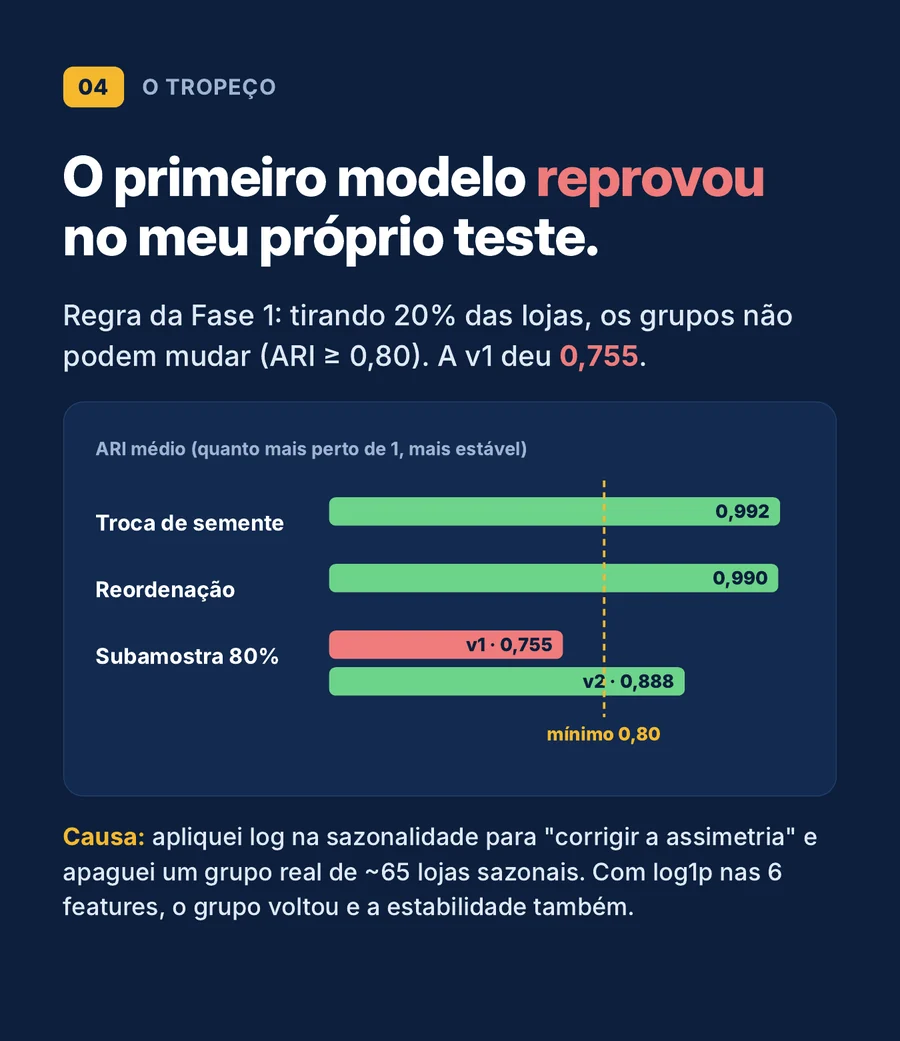
Na fase de negócio eu escrevi uma regra: se eu tirar 20% das lojas e rodar de novo, os grupos não podem mudar. Meta de gerente não pode depender de sorteio. O primeiro modelo passou na troca de semente, passou na reordenação das linhas — e caiu na subamostragem.
A reprovação
ARI de 0,755, abaixo do mínimo de 0,80. Em metade das subamostras (51%), a concordância ficava abaixo da régua. Na prática, uma em cada quatro lojas podia trocar de grupo dependendo de quais outras lojas estavam na base. Pior: uma solução com inércia só 0,17% menor movia 53 lojas. O modelo parecia bom em silhueta e era frágil exatamente onde importava.
Três problemas, nenhum no algoritmo
1. Eu tratei um sinal como ruído. A sazonalidade tinha uma cauda longa, e eu apliquei log para "corrigir a assimetria". O skew foi a zero — e junto sumiu um grupo real de lojas muito sazonais:
| Sazonalidade | Skew | Lojas acima de 2 desvios | z máximo |
|---|---|---|---|
| Original | 2,20 | 31 | 8,94 |
| log1p | 1,86 | 31 | 8,28 |
| log | 0,07 | 27 | 4,85 |
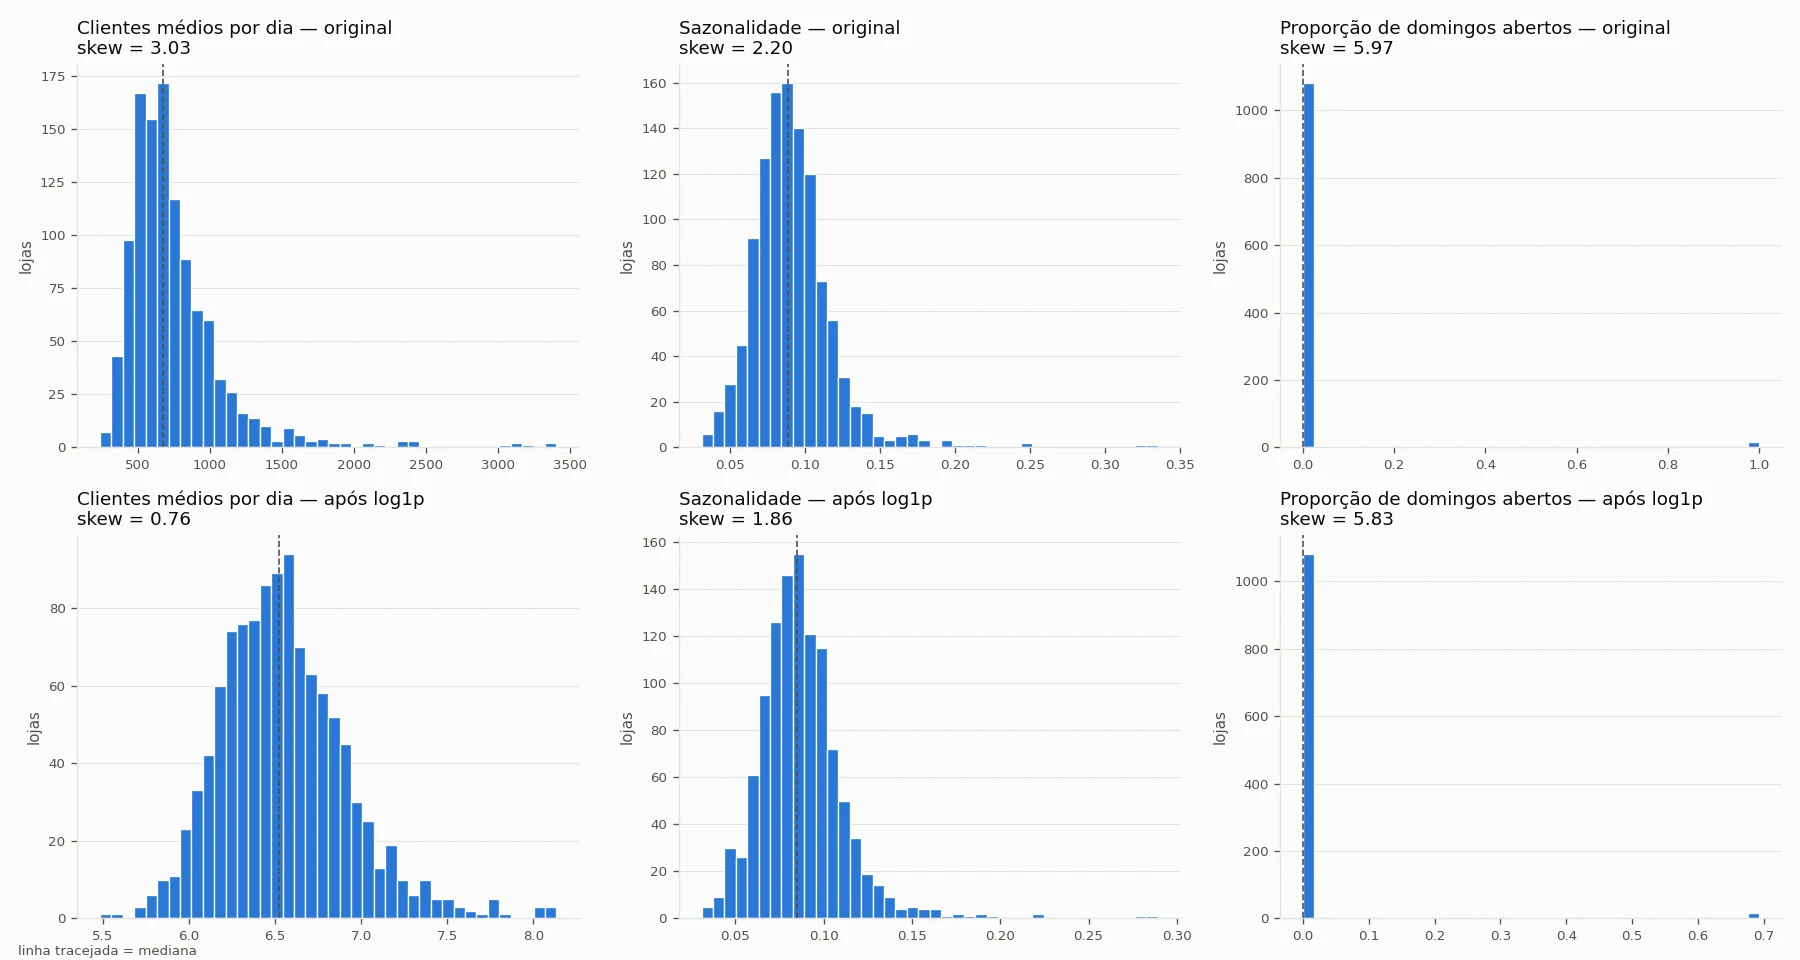
O log puro comprimiu a cauda até as lojas sazonais se diluírem nos outros grupos. A leitura mais provável: sem um grupo próprio, elas ficavam entre centroides e eram as primeiras a trocar de lugar quando a amostra mudava. Com log1p, a cauda volta e o grupo de 65 lojas reaparece, estável.
2. Features certas para outra pergunta. Comparei o meu conjunto com um conjunto de referência, usando o mesmo protocolo de teste. O primeiro usava pico de sábado, efeito da promoção só em dias úteis e sazonalidade em janela comum; o segundo, volatilidade, efeito da promoção em todos os dias e sazonalidade normalizada pelo ano. O segundo explicava 28,3% da variação da venda contra 16,5% do meu. Como a meta é de venda, troquei.
3. Um teste fraco esconde o problema. Uma reordenação e dez subamostras dão um número bonito por sorte. Para ter certeza, o protocolo virou 30 sementes, 30 reordenações e 100 subamostras de 80% — e os quatro pipelines candidatos foram medidos por ele:
| Pipeline (k = 5) | Silhueta | ARI semente | ARI subamostra | Subamostras < 0,80 | η² da venda |
|---|---|---|---|---|---|
| 1. Original (log na sazonalidade) | 0,180 | 0,900 | 0,755 | 51% | 14,5% |
| 2. Original, trocando só log por log1p | 0,183 | 0,893 | 0,815 | 24% | — |
| 3. Features originais + log1p nas seis | 0,184 | 0,982 | 0,892 | 13% | 16,5% |
| 4. Features finais + log1p nas seis | 0,202 | 0,992 | 0,898 | 14% | 28,3% |
A tabela separa as duas causas com clareza. A estabilidade veio da transformação: com log1p nas seis, o conjunto antigo (3) quase empata com o final (0,892 contra 0,898). O poder de explicação veio da escolha das features: 28,3% contra 16,5% da venda. O pipeline 4 foi adotado.
A entrega que vai para o Comercial: a meta de cada loja
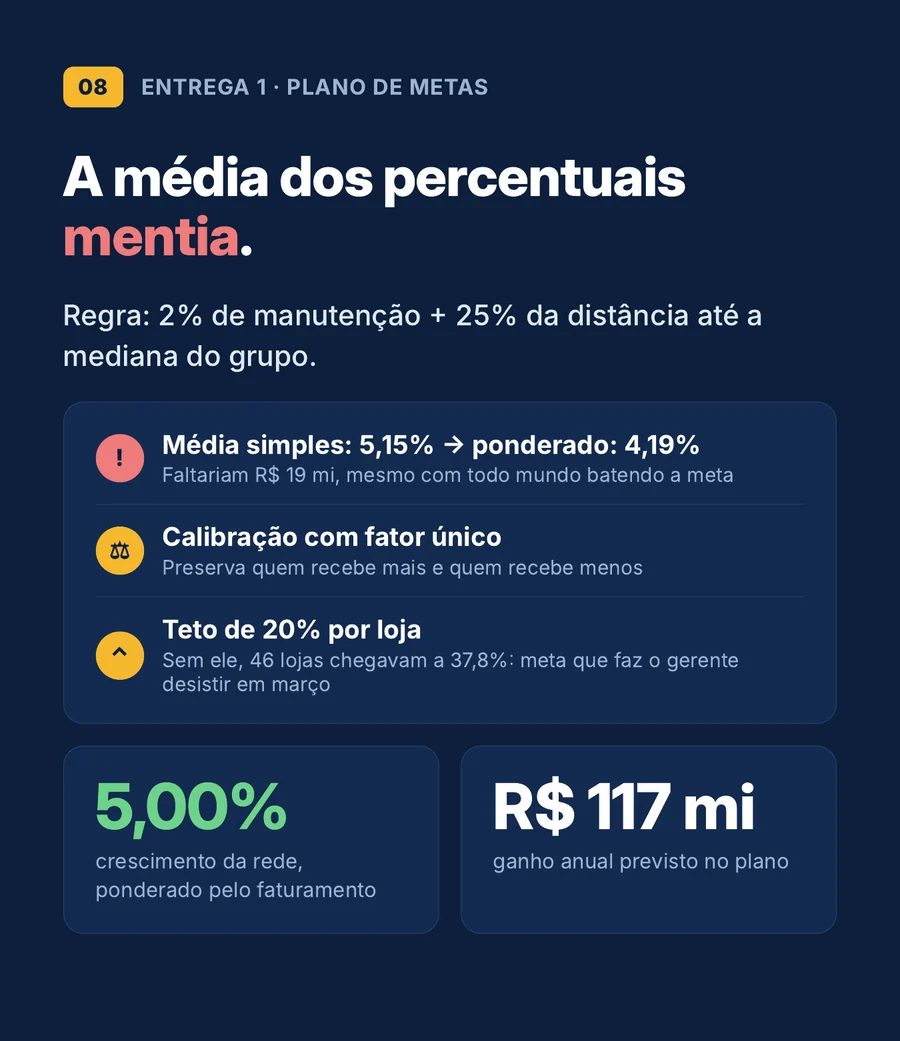
A regra: quem está atrás dos pares recebe mais — 2% + 25% da distância até a mediana do grupo — e quem já está na mediana ou acima recebe a meta de manutenção. A média das metas deu 5,15%. A diretoria prometeu 5% ao conselho. Bateu? Não.
| Etapa | Média simples | Crescimento ponderado | Leitura |
|---|---|---|---|
| Metas iniciais | 5,15% | 4,19% | Faltariam R$ 19,0 mi por ano, mesmo com todo mundo batendo a meta |
| Calibradas, sem teto (fator 1,1932) | 6,14% | 5,00% | 46 lojas acima de 20%, com máximo de 37,8% |
| Calibradas, com teto de 20% (fator 1,2202) | 6,05% | 5,00% | 47 lojas no teto; manutenção sobe de 2,39% para 2,44% |
- Média simples mente. As lojas com meta alta são as pequenas — estão abaixo da mediana. As 559 lojas na mediana ou acima recebem só 2% e são 60,9% do faturamento. Ponderando pelo faturamento, o crescimento real era 4,19%.
- Calibração com fator único. Um multiplicador sobre todas as metas, recalculado por iteração, preserva quem recebe mais e quem recebe menos e faz a rede fechar em exatos 5,00%.
- Teto de 20%. Sem ele, 46 lojas recebiam até 37,8%. Isso recria o problema que abriu o case: o gerente olha a meta e desiste em março. Com o teto, o esforço é redistribuído — a meta média das lojas atrasadas cai de 9,91% para 9,69% e a de manutenção sobe para 2,44%.
| Faixa de meta | Lojas | % |
|---|---|---|
| Manutenção (2,44%) | 559 | 50,1 |
| Manutenção a 5% | 117 | 10,5 |
| 5% a 10% | 214 | 19,2 |
| 10% a 15% | 121 | 10,9 |
| 15% a 20% | 57 | 5,1 |
| No teto (20%) | 47 | 4,2 |
A planilha entregue ao Comercial tem uma linha por loja, com grupo, benchmark, gap, meta, prioridade ("Ação" para gap ≥ 10%: 417 lojas) e as marcações de fronteira. O limiar de ação e o teto são escolhas de negócio e ficam editáveis na própria planilha.
O que fica deste projeto
- Corrigir assimetria por reflexo pode apagar o padrão que você quer encontrar. Skew alto às vezes é a estrutura, não o defeito.
- Teste de estabilidade só vale se for difícil de passar. E ele precisa ser escrito antes de ver o resultado.
- Média de percentuais não é crescimento em reais.
- Meta impossível não é ambiciosa, é desmotivadora.
Parte 9 de 9 da série 1.115 lojas, 1 régua injusta. O mapa completo da série reúne todas as partes, os cinco grupos e os números finais. O código, os notebooks e a documentação estão no repositório no GitHub ↗.