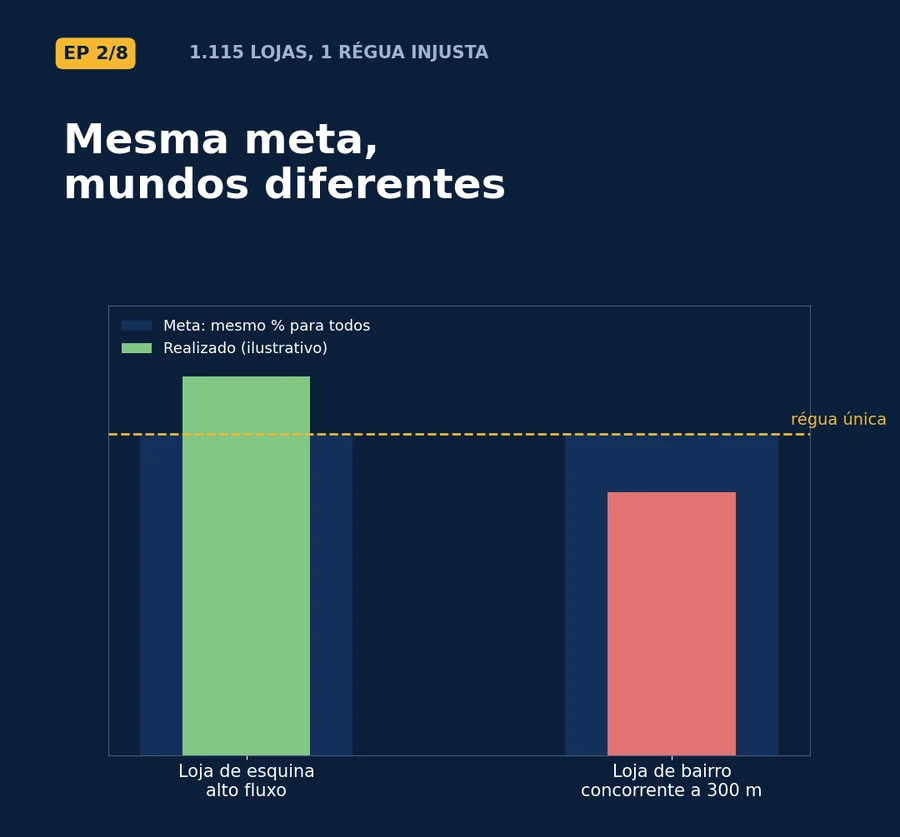
A régua única parece neutra porque trata todo mundo igual. Mas tratar igual quem é diferente não elimina a injustiça — só a distribui ao acaso. E esse acaso vaza do Comercial para o Trade, o Supply e a Expansão.
Quatro áreas, uma mesma falha
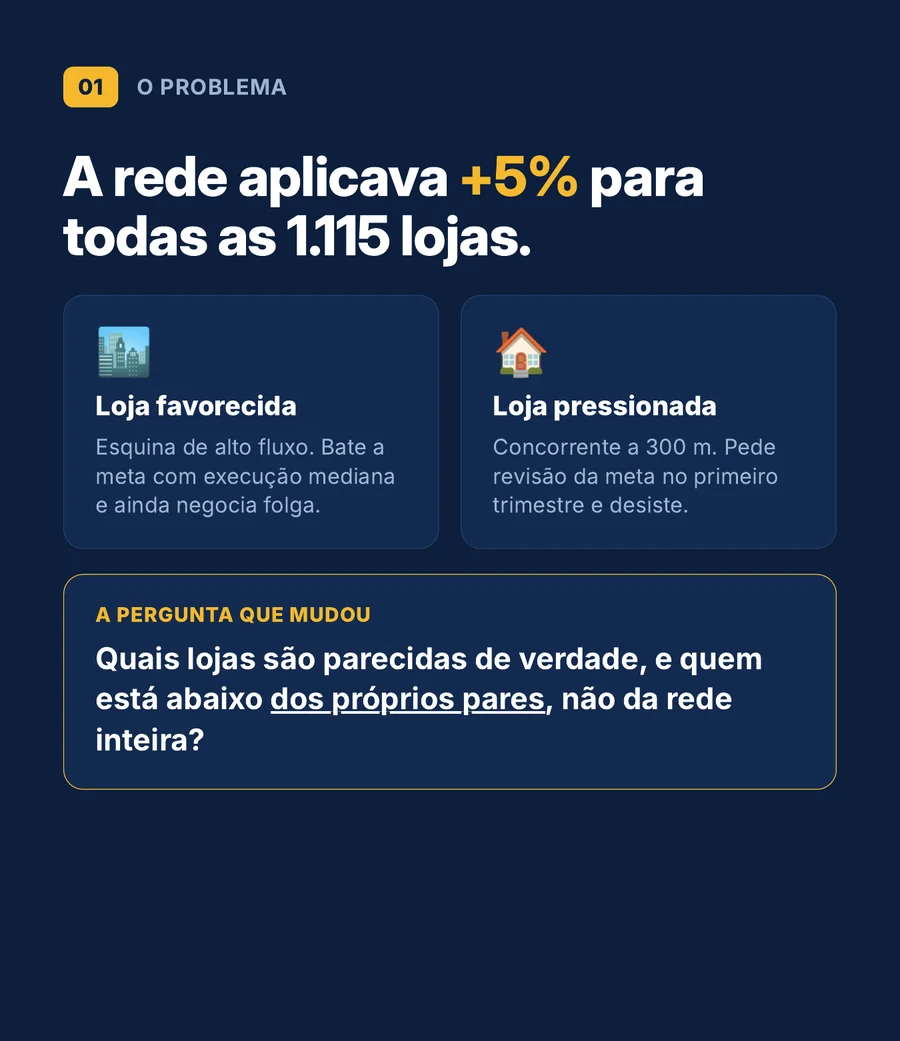
A pergunta "com quem esta loja se compara?" não é só da área comercial. Ela aparece em toda decisão que hoje usa a média da rede como referência:
| Área | Como a régua única atrapalha | O que ela precisa |
|---|---|---|
| Comercial | Meta que premia ou pune formato de loja, não execução | Meta por grupo de lojas comparáveis |
| Trade marketing | Verba vai para a loja que "está sofrendo", não para a que responde a campanha | Saber onde a promoção gera retorno |
| Supply | Duas lojas com o mesmo sortimento cadastral: uma vende em dia útil, outra depende do sábado | Mix e reposição pelo padrão de demanda |
| Expansão | Uma loja nova não tem histórico nem com quem ser comparada | Enquadrar a loja nova num grupo |
Por que clusterização
O enquadramento do problema decide o algoritmo, não o contrário. Não existe rótulo verdadeiro de "grupo" — ninguém sabe a resposta certa de antemão — então não é classificação. E ninguém pediu previsão de venda, então não é regressão. É aprendizado não supervisionado: encontrar grupos de lojas que se comportam de forma parecida.
Duas decisões saíram daqui e valeram o projeto inteiro:
- Tipo de loja e sortimento ficam fora do modelo. Eles são a segmentação que a rede já tem — o baseline que o modelo precisa superar. A parte 4 conta por quê.
- O projeto não é previsão de vendas, ranking geral da rede nem caça ao "k matematicamente ótimo". Maximizar silhueta não estava no escopo.
Cinco critérios, escritos antes do modelo
Antes de abrir os dados, o comitê fechou o que contaria como sucesso — e, mais importante, como cada critério seria provado. Critério sem prova vira opinião na reunião de resultado.
| Critério | Como seria provado |
|---|---|
| Interpretável | Perfil de cada grupo (medianas e z-score contra a rede); nome tirado das 2–3 variáveis mais distantes da rede. A validação final é humana. |
| Acionável | Matriz grupo × área com uma decisão concreta por célula. Se duas linhas forem iguais, os grupos se fundem. |
| Estável | ARI médio ≥ 0,80 em 30 reordenações das linhas, 30 sementes aleatórias e 30 subamostras de 80% das lojas. |
| Melhor que o baseline | η² dos grupos contra tipo de loja e sortimento em métricas de negócio — inclusive métricas que ficaram fora do modelo — e contra uma partição aleatória. |
| Quantificado em R$ | Gap até a mediana do grupo × dias de operação × % de captura; metas ponderadas somando exatamente +5%. |
Por que isso importa: a regra de estabilidade foi escrita aqui, antes de qualquer modelo. Foi ela que reprovou a primeira versão, meses depois. Se o critério tivesse sido definido depois de ver o resultado, a tentação de afrouxá-lo seria grande — e o projeto teria ido para a operação com uma em cada quatro lojas podendo trocar de grupo. A história está na parte 9.
Parte 2 de 9 da série 1.115 lojas, 1 régua injusta. O mapa completo da série reúne todas as partes, os cinco grupos e os números finais. O código, os notebooks e a documentação estão no repositório no GitHub ↗.