Todo ano o processo é o mesmo: pega o faturamento do ano anterior, aplica o crescimento prometido ao conselho e distribui o mesmo percentual para a rede inteira. Simples, transparente, fácil de comunicar. E cada vez mais injusto.
O case usa uma rede de varejo fictícia sobre uma base pública de vendas diárias de 1.115 lojas. A arquitetura, o código e todos os números são reais.
Duas linhas da mesma tabela, dois mundos
A loja de esquina, no centro, com alto fluxo, bate a meta quase todo ano com execução mediana. A loja de bairro, com um concorrente a menos de 300 metros, começa o ano pressionada e pede revisão já no primeiro trimestre. No relatório, as duas são linhas da mesma tabela, com o mesmo +5%. Na operação, não têm nada em comum.
O efeito não fica no gerente. O gerente favorecido entra no ano com folga para negociar recurso e preservar bônus; o pressionado perde a confiança no plano em março; e o supervisor passa o ano defendendo exceção em vez de discutir operação.
A pergunta que mudou
A pergunta de sempre era "essa loja está acima ou abaixo da média da rede?". Ela compara a loja com 1.114 outras que não têm o mesmo ponto, o mesmo concorrente nem o mesmo público. A pergunta deste projeto é outra:
Quais lojas são parecidas de verdade — e, dentro de cada grupo de pares, quem está abaixo do que os próprios pares entregam?
Antes de perguntar quanto uma loja vai vender, é preciso responder com quem ela deve ser comparada. É um problema de comparabilidade, não de previsão.
O que estava na mesa
Na soma, são R$ 5,87 bilhões de faturamento e 644 milhões de clientes registrados. E uma regra dada pela diretoria comercial logo no começo, que guiou todas as decisões depois:
"Se a análise não muda a meta, a verba, o estoque ou a decisão de expansão, ela não é uma solução. É só uma apresentação bonita."
O caminho: seis fases, duas entregas
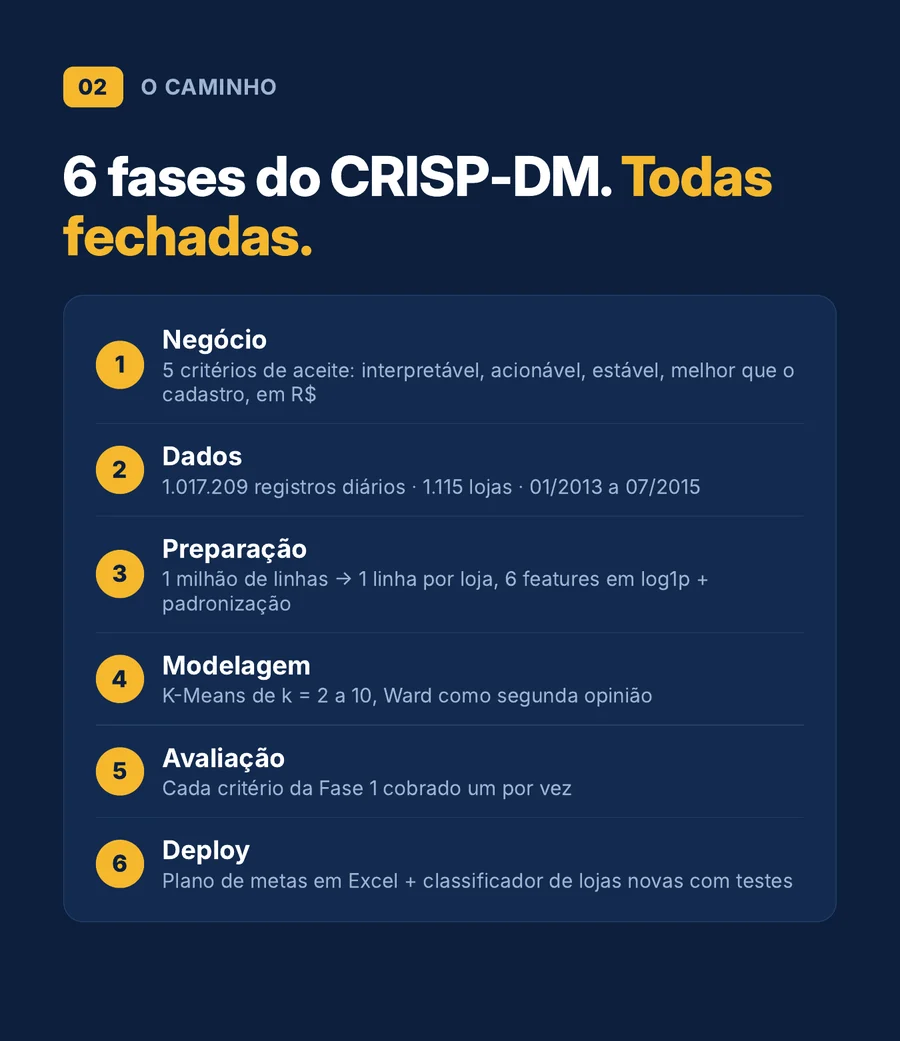
O projeto seguiu as seis fases do CRISP-DM, e cada uma tem uma parte nesta série. O ponto de chegada não é um gráfico de clusters: são duas ferramentas que alguém da operação usa sem abrir um notebook.
- Plano de metas por loja, em Excel, calibrado para a rede fechar exatamente os +5% prometidos, ponderados pelo faturamento.
- Classificador de lojas novas, que enquadra uma loja num dos grupos sem retreinar o modelo, com 14 testes automatizados.
O spoiler honesto
O resultado foram cinco grupos de lojas com nomes que um gestor entende, que explicam 28,3% da variação da venda contra 2,8% do tipo de loja do cadastro, e uma oportunidade de R$ 51,4 milhões por ano num cenário conservador. Mas o primeiro modelo reprovou num teste que eu mesmo tinha escrito, e essa reprovação foi a parte mais útil do projeto. Ela tem uma parte só para ela, a última.
Parte 1 de 9 da série 1.115 lojas, 1 régua injusta. O mapa completo da série reúne todas as partes, os cinco grupos e os números finais. O código, os notebooks e a documentação estão no repositório no GitHub ↗.