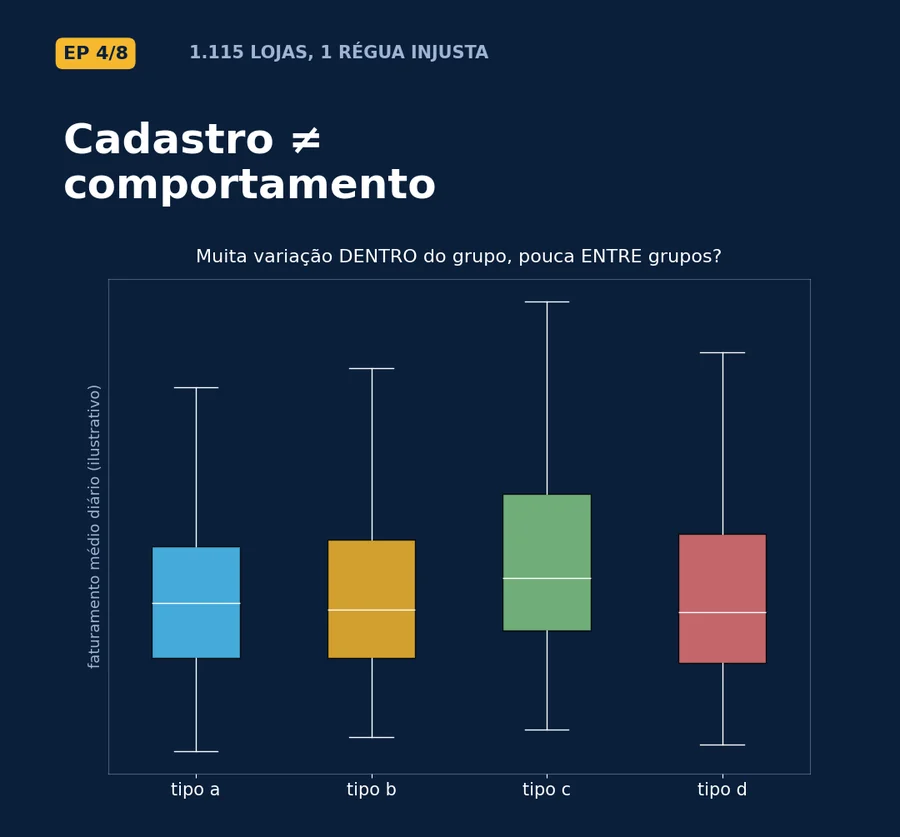
A rede já tem uma segmentação: tipo de loja (a, b, c, d) e sortimento. A decisão que parece contraintuitiva é deixá-las fora do modelo. Se entrassem, o algoritmo tenderia a reconstruí-las — e o projeto terminaria renomeando o que já existe.
O que o tipo de loja realmente separa
A hipótese era que o cadastro serve para organizar relatório, mas não responde "quais lojas são comparáveis?". Os dados confirmaram por dois lados:
- Três tipos que vendem o mesmo. Os tipos a, c e d vendem entre R$ 6.824 e R$ 6.917 por dia aberto — praticamente iguais entre si — e a dispersão dentro de cada tipo é alta (coeficiente de variação da venda de 0,26 a 0,45). Grupo com muita variação dentro e pouca entre não serve de régua.
- Um tipo que é outro negócio. O tipo b tem 17 lojas (1,5% da rede), 2,6× os clientes da média, o menor ticket (R$ 5,17) e abre 98% dos domingos. Não é ruído para remover: é um modelo de negócio real.
No fim do projeto, o número que resume o baseline: o tipo de loja explica 2,8% da variação da venda média. Os clusters explicam 28,3% — a comparação completa está na parte 6.
O que entra, o que fica de fora, e por quê
O critério para cada coluna do cadastro foi a pergunta de negócio, não a correlação:
| Coluna | Decisão | Motivo |
|---|---|---|
distancia_concorrente | entra | Contexto competitivo que a loja não escolhe — e conhecido antes da abertura, útil para a Expansão |
tipo_loja, sortimento | baseline | São a segmentação a superar; dentro do modelo, seriam reconstruídas |
promo_continua | só descrição | É política decidida pela empresa, não comportamento da loja. Usá-la tornaria circular a decisão do Trade |
loja | fora | Identificador |
O caso da promo_continua é o mais sutil. Se o modelo agrupasse lojas pela adesão ao programa de promoção, o Trade receberia como "descoberta" a decisão que ele mesmo tomou. A variável fica na descrição dos grupos, não na definição deles.
Os clusters reconstruíram o cadastro?
Não. A concordância entre os cinco grupos finais e o cadastro é baixa:
| Categoria do cadastro | ARI | NMI |
|---|---|---|
tipo_loja | 0,118 | 0,148 |
sortimento | 0,056 | 0,065 |
E aqui veio o achado mais bonito do projeto. O modelo nunca recebeu tipo_loja, mas 13 das 17 lojas do tipo b caíram no mesmo cluster — o "Alto fluxo, cesta pequena". Ao acaso, o esperado seriam 2,7 (p = 4,2 × 10⁻⁸). O que as une é o ticket: 13 delas estão entre os 17 menores tickets da rede. Do mesmo jeito, 265 das 348 lojas do tipo d caíram no cluster "Destino de cesta grande".
As 4 lojas do tipo b que ficaram de fora se separaram por promoção e volatilidade, não por porte: as que foram para o cluster 0 têm efeito de promoção de +68,9%; as que foram para o cluster 2, de −0,7%. Mesmo cadastro, comportamentos opostos.
O baseline não é "errado". Ele reflete a estrutura operacional da empresa, e onde o cadastro captura comportamento real — como o tipo b — o modelo o reencontra sozinho. O ponto é que meta precisa de comparabilidade de comportamento, e o cadastro foi desenhado para outra pergunta.
Parte 4 de 9 da série 1.115 lojas, 1 régua injusta. O mapa completo da série reúne todas as partes, os cinco grupos e os números finais. O código, os notebooks e a documentação estão no repositório no GitHub ↗.