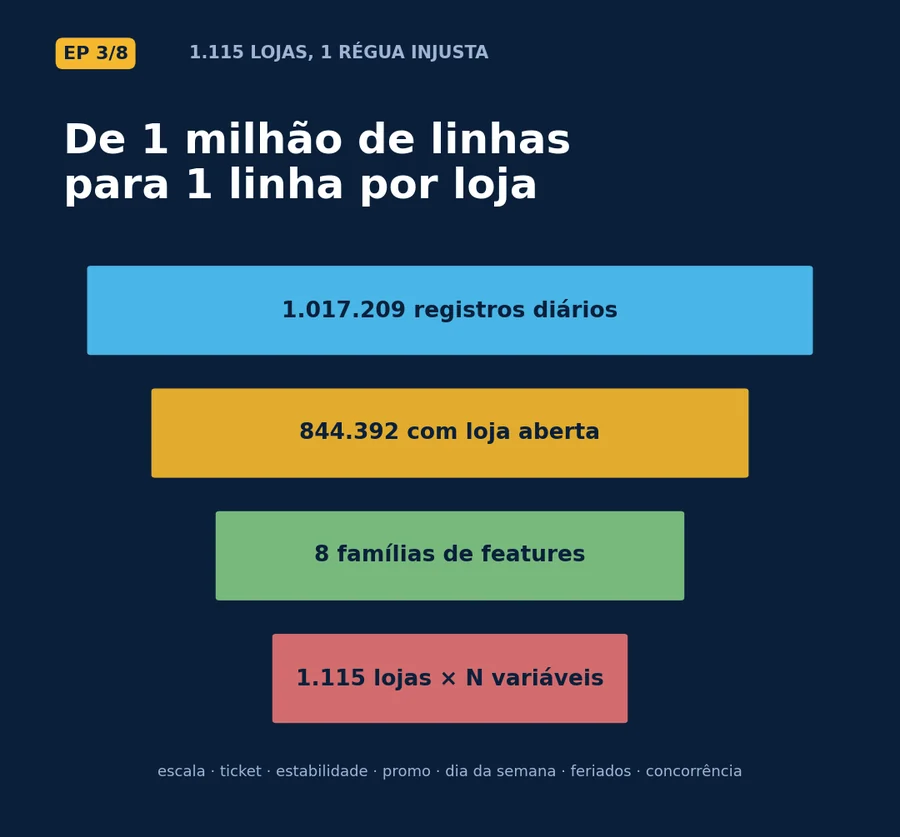
A clusterização trabalha com uma linha por loja. A base chega com um milhão de linhas por dia de loja. Entre uma coisa e outra há seis armadilhas — e a mais perigosa não aparece como nulo, nem como zero. As linhas simplesmente não existem.
As armadilhas da base diária
- Dias fechados zeram a média. 17% das linhas são de loja fechada. A média sobre todos os dias é exatamente a média em dia aberto × a proporção de dias abertos — ou seja, mede funcionamento, não capacidade de venda. Só por abrir aos domingos, uma loja sobe em média 108 posições no ranking.
- Um buraco sistemático. 180 lojas não têm nenhuma linha de 01/07/2014 a 31/12/2014 — os mesmos 184 dias em todas. Não há nulo para o
.isnull()encontrar. - Soma distorce, média não. No ranking por faturamento total, 98 das 180 lojas incompletas caem no pior quartil, quando o esperado seria 45 (p ≈ 10⁻²⁰). Pela média em dia aberto, caem exatamente 45 (p = 0,54).
- Registro inconsistente. 54 linhas com loja aberta e faturamento zero, em 41 lojas.
- Domingo é raro. Só 33 lojas abrem aos domingos — e 17 delas são de um mesmo tipo do cadastro.
- Distância com cauda longa. A distância ao concorrente vai de 20 a 75.860, com skew de 2,93. As 5% lojas mais isoladas concentram 59,6% da variância.
Cada defeito virou uma regra de engenharia. As métricas de desempenho são calculadas só sobre dias de operação (aberta = 1 e faturamento > 0): 844.338 linhas das 1.017.209, com as 1.115 lojas presentes. E por causa do buraco, só entram médias, proporções e taxas — nunca somas.
O buraco distorce as features temporais?
Não dava para assumir. O teste: nas lojas completas, recalcular a feature removendo o 2º semestre de 2014 — exatamente o que as 180 incompletas sofrem — e medir quanto ela muda.
| Feature | Variação mediana sem o período | Spearman entre versões | Conclusão |
|---|---|---|---|
| Volatilidade | −0,2% | 0,994 | Não distorce: calculada no histórico inteiro |
| Sazonalidade | +8,3% | 0,921 | Distorce: precisa de tratamento |
A sazonalidade passou a ser calculada mês a mês dividida pela média do próprio ano da loja, o que neutraliza o semestre ausente.
Como a loja vende, não só quanto
Se o modelo recebesse só faturamento, os grupos seriam "lojas grandes, médias e pequenas" — e isso a rede já sabia. O valor está em capturar o comportamento. Nove candidatas foram construídas, em cinco blocos:
| Bloco | Feature | Como é calculada |
|---|---|---|
| Porte | venda_media_dia | Faturamento médio por dia de operação |
| Porte | clientes_medios_dia | Clientes médios por dia de operação |
| Porte | ticket_medio | Venda média ÷ clientes médios |
| Promoção | efeito_promo | Venda média com promoção ÷ sem promoção − 1 |
| Ritmo | volatilidade | Coeficiente de variação da venda diária |
| Ritmo | sazonalidade | Cada mês ÷ média do próprio ano; desvio entre os 12 meses |
| Formato | prop_domingos_abertos | Domingos abertos ÷ domingos registrados |
| Formato | pico_sabado | Venda média de sábado ÷ venda média de segunda a sexta |
| Concorrência | distancia_concorrente | Cadastro; 3 nulos imputados pela mediana (2.325) e marcados |
Uma observação sobre promoção: a coluna promo é o calendário da rede — cerca de 38% dos dias, igual para todas as lojas. Medir "% de dias em promoção" não diferencia ninguém. O que diferencia é a resposta à promoção: na média, a venda sobe 41,4% nos dias promocionais, numa faixa que vai de −6,9% a +144,9%.
Nove candidatas, seis no modelo
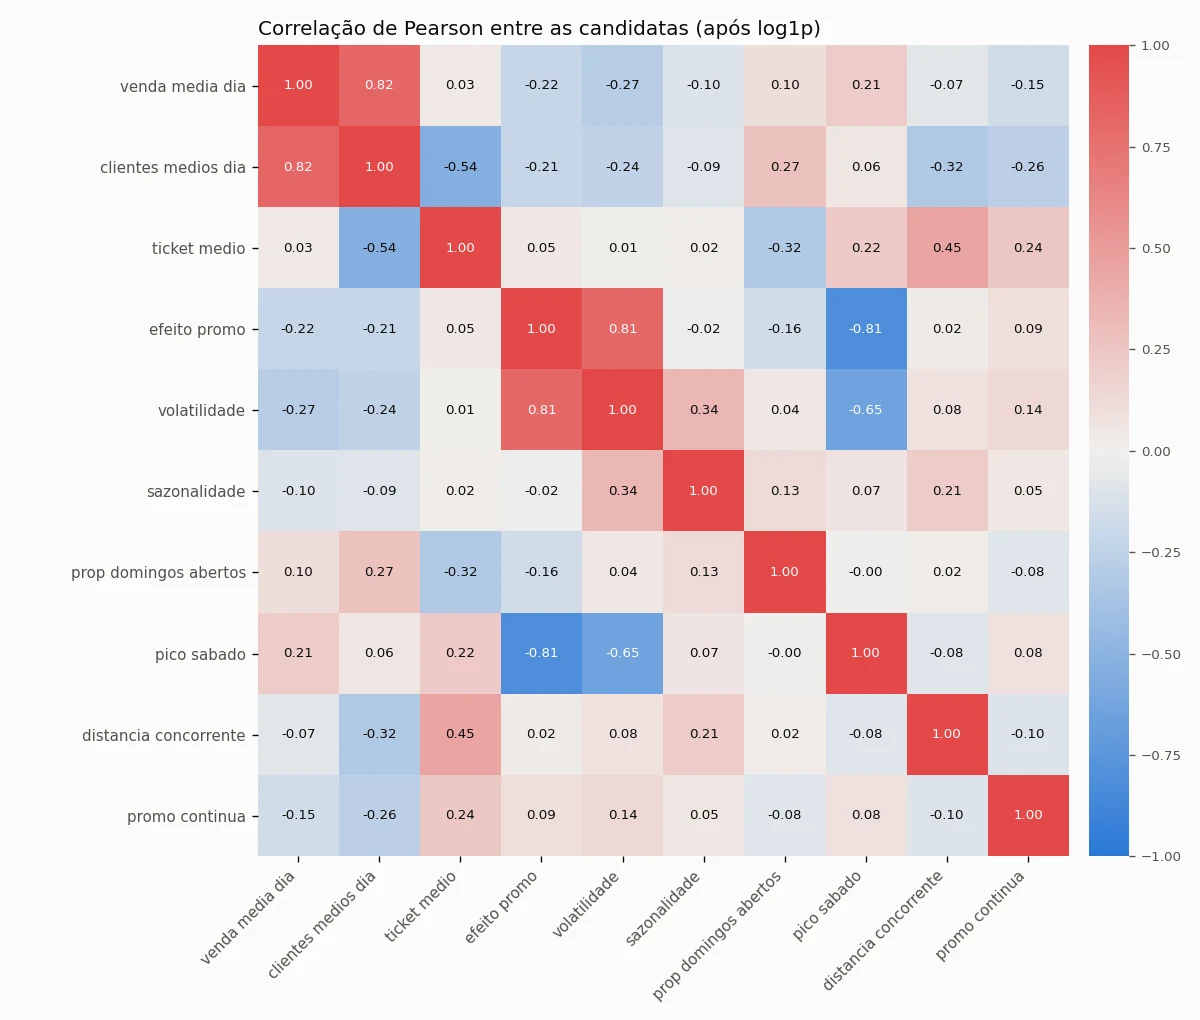
- Clientes saiu: venda = clientes × ticket é uma identidade exata. Manter os três contaria o porte duas vezes.
- Pico de sábado saiu: correlação de −0,81 com o efeito da promoção, porque a promoção nunca ocorre no fim de semana — os dias "sem promoção" incluem os sábados.
- Domingos abertos saiu: 97,0% das lojas estão em zero. Log1p, binarização, Yeo-Johnson e quantil deixam o skew entre 5,56 e 5,97. Nenhuma transformação cria variação onde há um valor só.
- Efeito da promoção e volatilidade ficaram, juntos, mesmo com correlação de 0,81. Promoção interessa ao Trade; oscilação, ao Supply. O preço, assumido e registrado, é dar mais peso a essa dimensão.
| Feature do modelo | Dimensão | Skew original | Skew após log1p |
|---|---|---|---|
venda_media_dia | Porte | 1,75 | 0,30 |
ticket_medio | Padrão de compra | 0,28 | −0,30 |
efeito_promo | Resposta à promoção | 0,68 | 0,22 |
volatilidade | Oscilação diária | 0,72 | 0,55 |
sazonalidade | Variação ao longo do ano | 2,20 | 1,86 |
distancia_concorrente | Contexto competitivo | 2,93 | −0,35 |
As seis passam por log1p e depois por padronização (StandardScaler), para que uma feature em reais não engula uma feature em percentual. Matriz final: 1.115 × 6, sem nulos.
Repare na sazonalidade: o skew continua alto depois do log1p (1,86). Na primeira versão do pipeline eu "corrigi" isso com log puro e zerei a assimetria. Foi o erro mais caro do projeto — a cauda era um grupo real de lojas. A conta está na parte 9.
Parte 3 de 9 da série 1.115 lojas, 1 régua injusta. O mapa completo da série reúne todas as partes, os cinco grupos e os números finais. O código, os notebooks e a documentação estão no repositório no GitHub ↗.