Fase 6 do CRISP-DM: implantação. É a que quase todo portfólio pula, porque é onde o projeto para de ser gráfico e vira ferramenta — e onde aparecem perguntas que nenhuma métrica de validação responde. Este texto é o que precisou existir para o modelo de risco da Aurora sair do notebook, e o que aprendi ao colocá-lo online de verdade.
Está no ar: o motor de decisão roda aqui no site, dentro do seu navegador. Preencha uma proposta, veja a probabilidade, o custo dos dois lados e a explicação SHAP daquele cliente. A segunda metade deste artigo conta como um modelo de gradient boosting foi parar dentro de uma página estática.
Conferência de integridade antes de deixar alguém pontuar cliente
A primeira coisa que o app faz não é mostrar tela. É prever um cliente fixo e comparar o resultado com o valor gravado no treino, com tolerância de 1e-9:
# o cliente de referência tem que devolver sempre o mesmo número
pipeline = joblib.load(CAMINHO_MODELO)
obtido = pipeline.predict_proba(pd.DataFrame([CLIENTE_REFERENCIA]))[:, 1][0]
integro = abs(obtido - PROBABILIDADE_REFERENCIA) < 1e-9
O motivo é específico e desagradável: uma versão diferente do LightGBM carrega o mesmo arquivo .joblib e prevê valores diferentes — em silêncio. Sem exceção, sem aviso, sem nada quebrar. O app continua funcionando e as decisões continuam saindo; só param de ser as decisões que você validou.
A conferência transforma isso em erro visível. Se o número não bater, a tela mostra o esperado, o obtido, e st.stop() — ninguém pontua cliente nenhum.
Esse teste custa uma linha e uma constante. É o tipo de proteção que só parece exagero até o dia em que alguém atualiza uma dependência num ambiente de produção e o modelo passa a decidir outra coisa sem que ninguém perceba.
A política dentro da tela, não num PDF
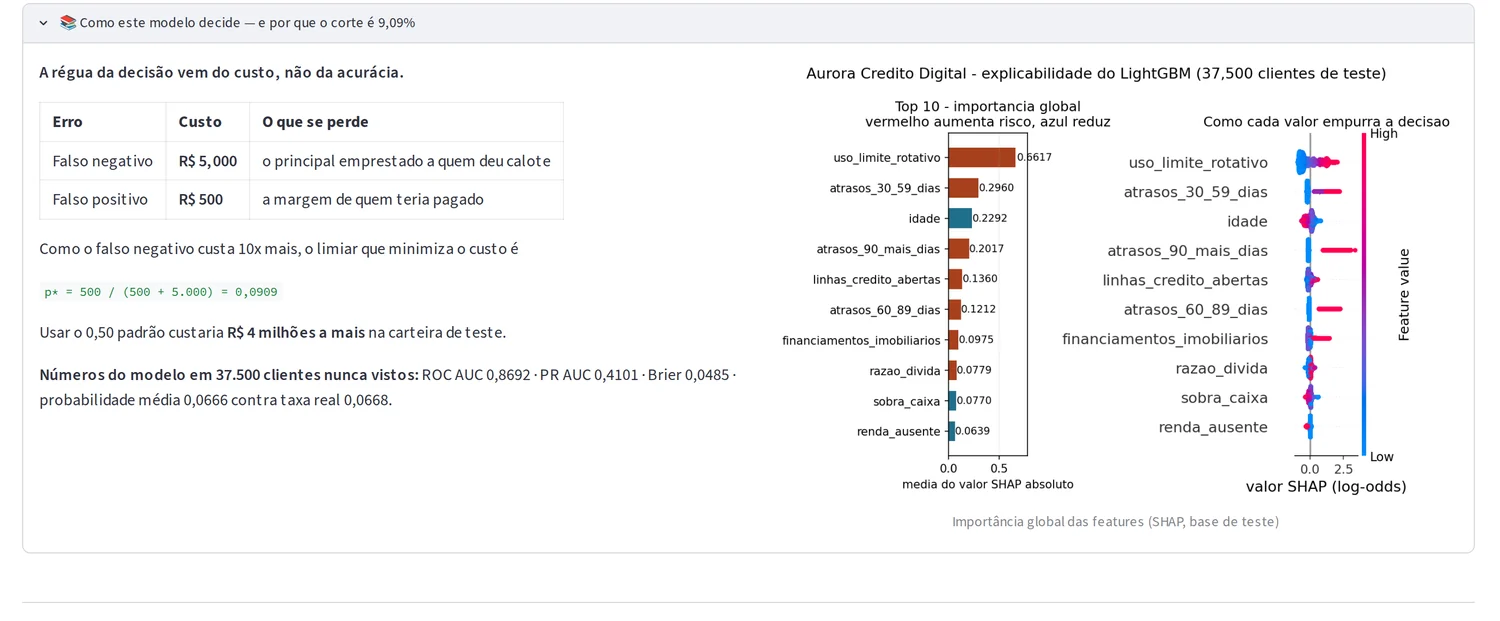
O analista não precisa acreditar no corte de 9,09%: ele confere de onde saiu. Custo do falso negativo (R$ 5.000), do falso positivo (R$ 500), a razão de 10 para 1 e a derivação:
p* = custo_FP / (custo_FP + custo_FN)
p* = 500 / (500 + 5.000) = 0,0909
Colocar a política na tela muda a conversa. Quando alguém discorda da taxa de negativa, a discussão vai direto para os custos — que são premissa de negócio, discutível — em vez de virar desconfiança genérica do modelo.
Dez campos, dezesseis features, e dois checkboxes que não são detalhe
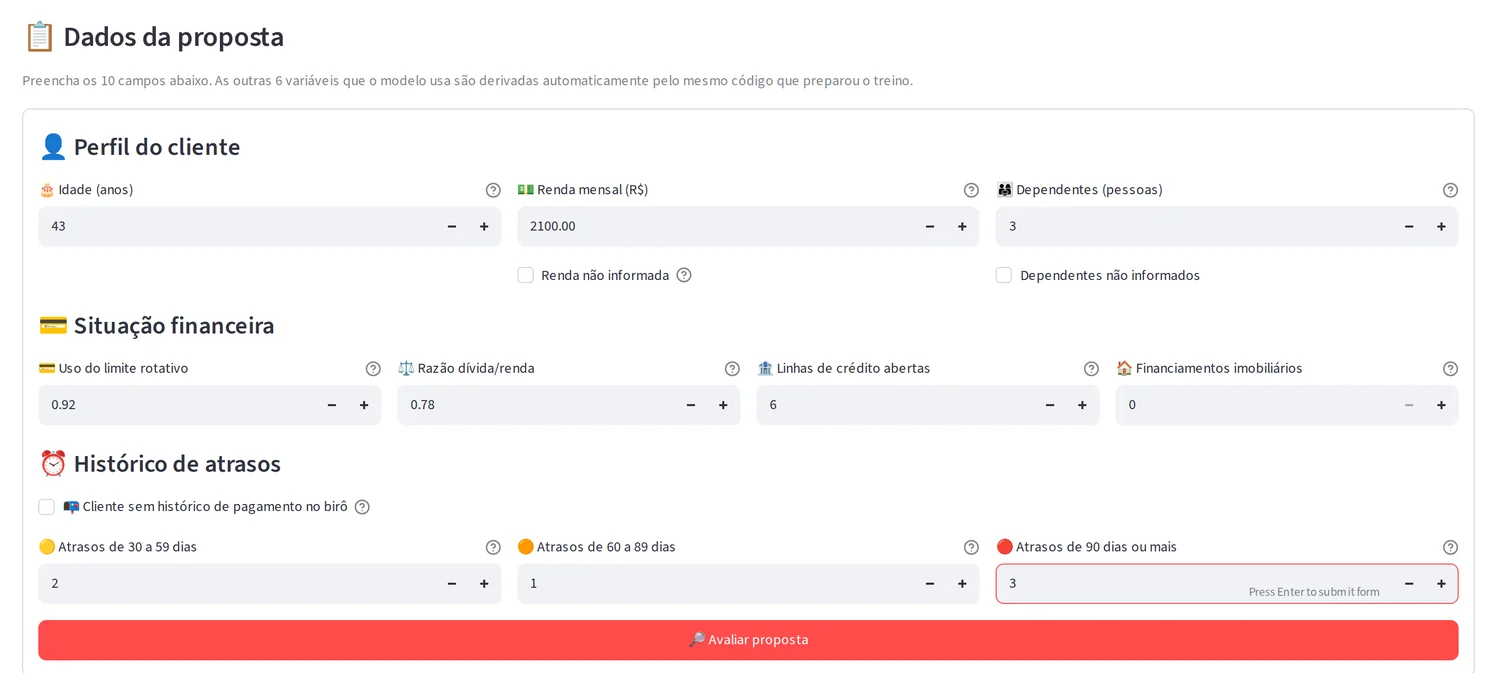
O formulário pede dez valores; o pipeline deriva as outras seis sozinho. E dois checkboxes que parecem acessório carregam informação real, apurada na exploração da base:
| Marcação | O que significa | Inadimplência do grupo |
|---|---|---|
| Renda não informada | o campo fica vazio e vira a flag renda_ausente | 5,61% contra 6,95% |
| Sem histórico no birô | grava o código 98 nas três colunas de atraso | 54,65% contra 6,60% |
Quem não informa renda inadimple menos — o contrário do que a intuição sugere. E quem chega com o código do birô inadimple 54,65%, oito vezes a taxa do resto da carteira. Campo em branco não é buraco a tapar com a mediana e seguir a vida: é sinal. Tratar as duas situações como ausência de dado jogaria fora as duas informações.
A decisão com preço dos dois lados
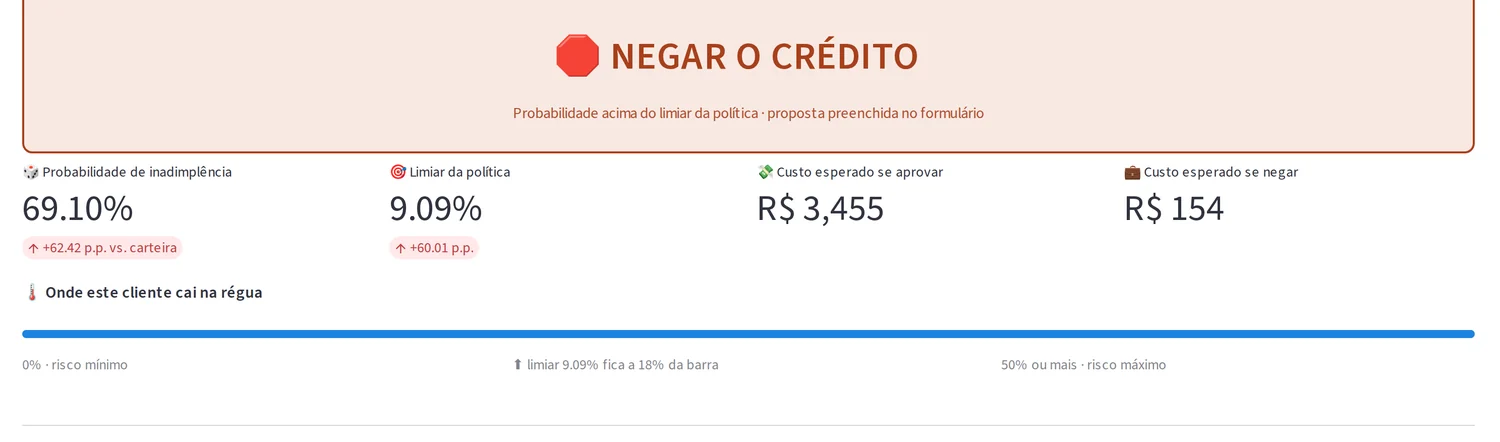
Mostrar só a probabilidade seria mostrar metade. O que decide é a comparação: R$ 3.455 se aprovar contra R$ 154 se negar. Do outro lado da carteira, um cliente de 0,87% inverte a conta — R$ 43 se aprovar contra R$ 496 se negar.
Escritos lado a lado, os dois números tornam o limiar óbvio sem precisar explicá-lo: o corte é exatamente onde as duas colunas se cruzam. É a mesma conta da parte 11 da série, agora por cliente em vez de por carteira.
SHAP daquele cliente, não do modelo em geral
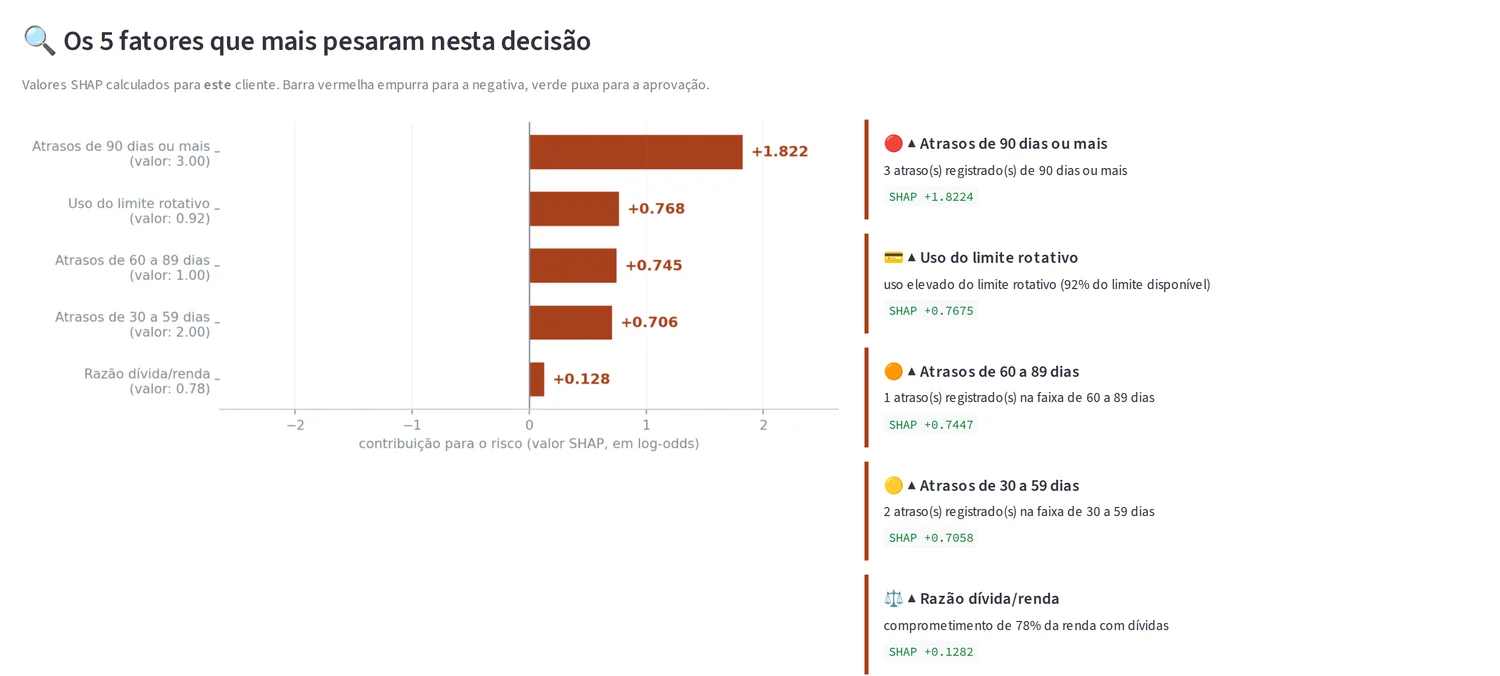
Importância global responde "o que o modelo olha". O comitê de crédito pergunta outra coisa: "por que este cliente". São perguntas diferentes e exigem contas diferentes — a primeira é uma média sobre a base, a segunda é a decomposição de uma predição.
Cada barra vira uma frase em português — "uso elevado do limite rotativo (92% do limite disponível)" — com o número exposto logo abaixo. A frase serve para a conversa; o número, para a auditoria. Esconder um dos dois empobrece o outro.
A carta de negativa sai pronta
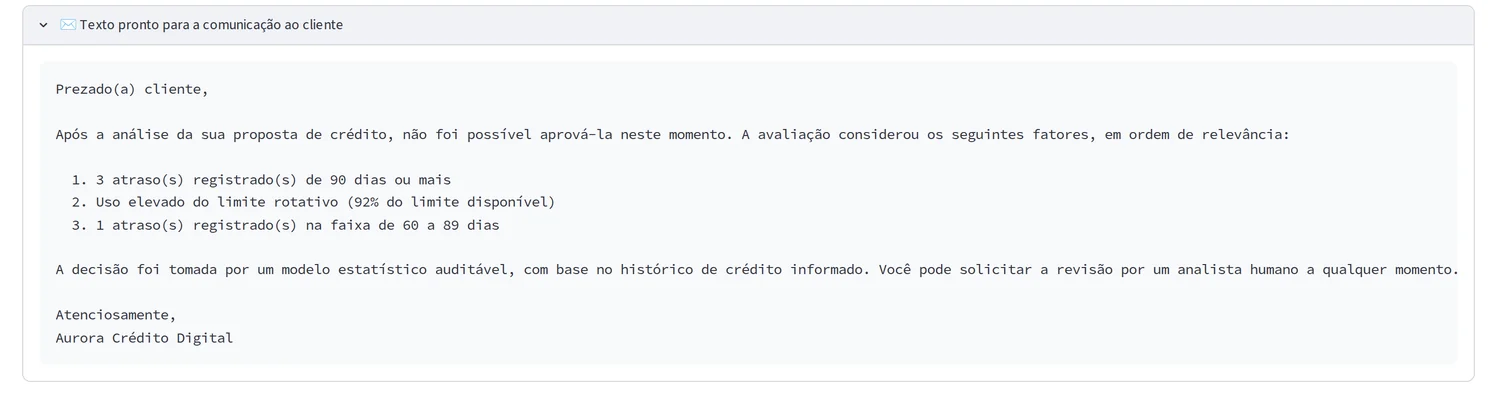
Essa é a parte que fecha o argumento da explicabilidade. Não basta o time de dados entender o modelo: alguém precisa dizer a um cliente — e eventualmente a um regulador — por que aquele crédito foi negado, em linguagem que não exige saber o que é log-odds.
O texto sai com os três fatores de maior peso, declara que a decisão veio de um modelo estatístico auditável e oferece revisão humana. Explicabilidade não é gráfico bonito para a apresentação interna; é isto aqui.
Base inteira, com o contrato de entrada na tela
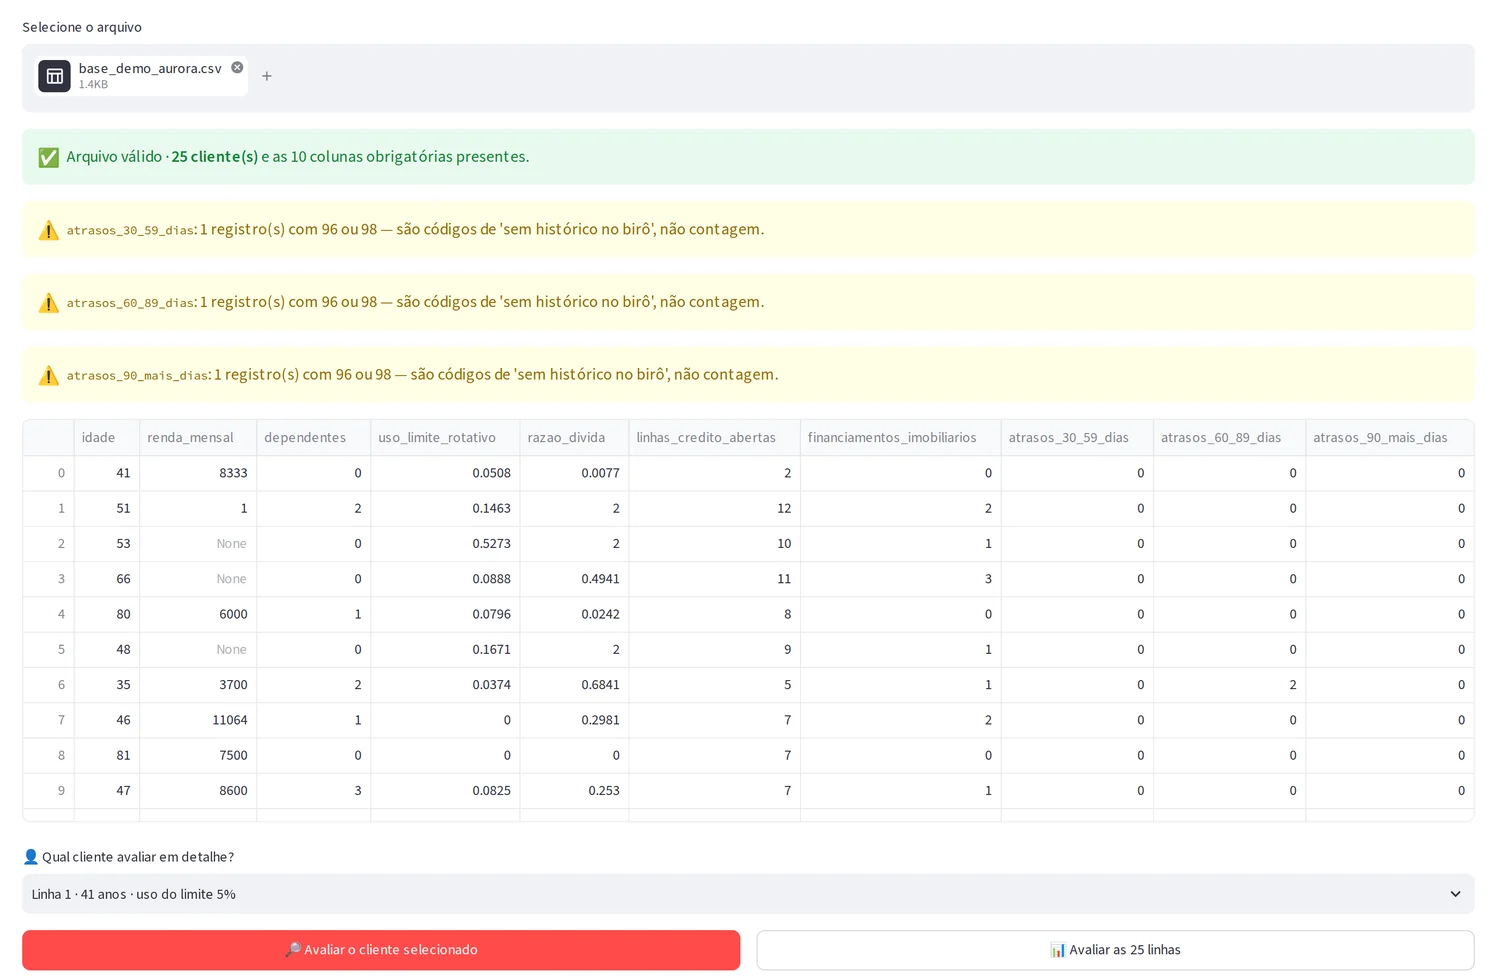
A aba de arquivo valida antes de pontuar, e o que ela procura veio direto dos problemas reais da base: achou 96 ou 98 nas colunas de atraso, avisa que são códigos de status do birô e não contagem; aceita renda em branco sem reclamar; ignora coluna extra, inclusive o alvo se vier junto.
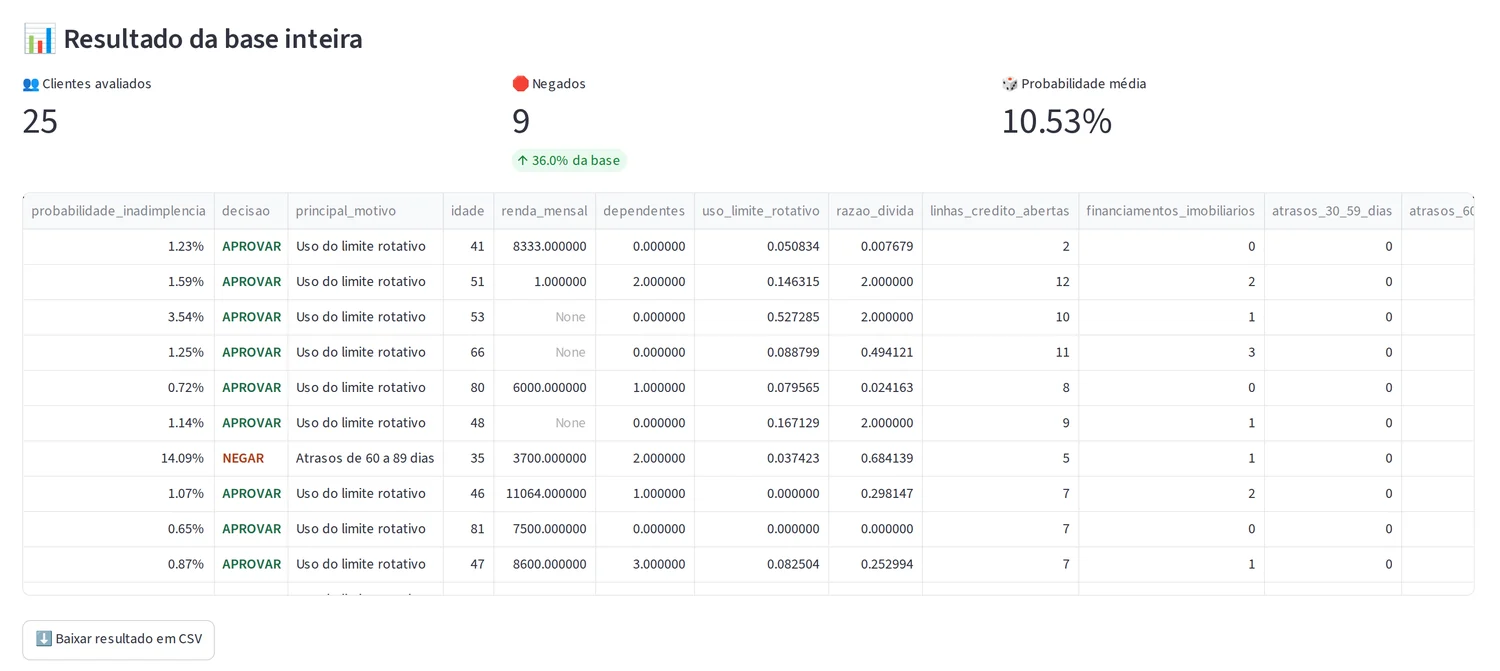
Na saída, cada linha volta com decisão e principal motivo. A coluna do motivo é o que permite a alguém revisar uma fila de negativas sem abrir o modelo.
A parte que não aparece na tela
O main.py não faz conta. Toda regra está no servico.py, que importa a mesma biblioteca que treinou o modelo. E o app consome um único artefato: o pipeline inteiro serializado, com os parâmetros de preparação dentro dele.
# os parâmetros aprendidos no treino viajam dentro do objeto
pipeline.named_steps["preparo"].parametros_
Existe um parametros_preparacao.json no projeto, e o app não o lê. Ler o JSON por fora abriria a porta para o app usar um conjunto de estatísticas diferente do que o modelo viu no treino — a mediana de renda de uma extração, o modelo de outra. É por isso que a preparação nunca diverge entre treino e produção: não existem duas versões do código, nem duas cópias das constantes.
O problema que o Streamlit não resolvia
Com o app funcionando, apareceu a questão que este artigo não tinha previsto: demorava para abrir.
Não é defeito do Streamlit. É o que ele é: um servidor Python que precisa estar de pé. No primeiro acesso depois de um tempo parado, alguém tem que acordar o contêiner e importar LightGBM, scikit-learn, SHAP, pandas e matplotlib antes de desenhar o primeiro pixel. Para uma ferramenta interna, tudo bem. Para um link num portfólio, onde o visitante decide em segundos se vale esperar, não.
A saída foi mudar o lugar onde o modelo roda. O pipeline treinado virou um artefato JSON — as 600 árvores achatadas em arrays, mais as duas medianas aprendidas no treino — e a página ganhou três funções escritas em JavaScript puro, sem biblioteca nenhuma:
| Etapa | O que faz | Equivalente em Python |
|---|---|---|
| preparação | deriva as 6 features e aplica as regras de tratamento | aurora/preparacao.py |
| predição | percorre as 600 árvores e soma as folhas | LGBMClassifier.predict_proba |
| TreeSHAP | decompõe a predição, exato | shap.TreeExplainer |
A terceira é a que dá trabalho. TreeSHAP não é uma aproximação por amostragem: é o algoritmo de Lundberg que percorre cada árvore mantendo o conjunto de caminhos possíveis, com as operações de estender e desfazer que tornam o cálculo exato viável em tempo polinomial. Portá-lo significava reimplementar essa mecânica inteira — e ter como provar que estava certa.
Como eu sei que a porta funcionou
Aqui a conferência de integridade do app Python virou também a régua da portabilidade. O mesmo cliente de referência tem que devolver o mesmo número:
// no navegador, sem nenhuma biblioteca
AuroraModelo.prever(AuroraModelo.preparar(CLIENTE_REFERENCIA, artefato), artefato)
// → 0.1569673418089306
// esperado pelo pipeline em Python:
// → 0.1569673418089306
Um caso não prova nada, então sorteei 400 clientes — incluindo os caminhos chatos: renda ausente, dependentes ausentes, sentinela do birô, razão dívida vazia — e comparei tudo contra o pipeline original:
| O que foi comparado | Maior diferença em 400 casos |
|---|---|
| Matriz de 16 features depois da preparação | 0 (idêntica) |
| Probabilidade de inadimplência | 1,1 × 10⁻¹⁶ |
| Valores SHAP das 16 features | 1,3 × 10⁻¹⁵ |
| Aditividade (base + Σ SHAP = log-odds) | 1,6 × 10⁻¹⁴ |
Essas diferenças são o limite da precisão de ponto flutuante de 64 bits, não do método — é a mesma ordem de grandeza que você obtém somando os mesmos números em ordem diferente. Vale registrar um detalhe que ajudou: antes de portar, conferi que o shap.TreeExplainer e o pred_contrib nativo do LightGBM concordavam exatamente entre si. Dois caminhos independentes chegando ao mesmo resultado deram a certeza de que havia um alvo fixo para mirar.
O que mudou na prática
Sem servidor, sem contêiner para acordar, sem fila. E um efeito colateral que acabou virando argumento de venda: os dados que o visitante digita não saem do dispositivo dele. Numa ferramenta que pede renda, dívida e histórico de atraso, isso deixa de ser detalhe técnico.
A diferença de custo entre as duas contas — 0,017 ms contra 6 ms — também mudou o desenho da tela. Numa base enviada por arquivo, a probabilidade é calculada para todas as linhas de imediato, e o TreeSHAP só roda nas que alguém vai de fato olhar. Na hora de exportar o CSV com o motivo de cada linha, o cálculo vai em blocos, devolvendo o controle ao navegador entre um e outro, para a aba não congelar.
O que esta versão não faz: o app Python continua sendo o caminho certo quando o modelo precisa ficar privado, quando a base é grande demais para o navegador, ou quando a decisão tem que ser registrada num sistema. Publicar as árvores num JSON é publicar o modelo — aqui isso é desejável, porque o objetivo é justamente que qualquer pessoa possa inspecioná-lo. Num produto real, raramente seria.
O ciclo fechado
Negócio → Dados → Preparação → Modelagem → Avaliação → Implantação. A sexta fase é a que transforma um número de ROC AUC em algo que alguém consegue usar, discordar e auditar. E foi só ao colocá-la de pé que apareceram as três perguntas que o resto do projeto não tinha feito: o modelo que carregou é o mesmo que eu validei? quem vai usar entende de onde vem o corte? e o cliente que recebeu "não" consegue saber por quê?
Nenhuma delas é respondida por uma métrica de validação. Todas são respondidas por uma tela.
Teste você mesmo: o motor de decisão está no ar, com perfis prontos para clicar — inclusive um cliente que fica a um centésimo de ponto percentual do limiar e é negado por causa disso.
Fase 6 da série Aurora — um modelo de risco de crédito do zero ao deploy. O mapa completo reúne as doze partes; veja também a documentação técnica, o epílogo sobre o desempate entre modelos e o código no GitHub ↗.