A leitura padrão da tabela final aponta XGBoost: ele lidera o ROC AUC. Escolhi LightGBM. Os dois estão tecnicamente corretos — e é exatamente isso que torna a comparação interessante. Quando dois modelos empatam de verdade, a escolha para de ser estatística e passa a ser de negócio. Este é o desempate, com a conta na mesa.
Primeiro: os dois empatam mesmo?
Cinco candidatos testados com validação cruzada StratifiedKFold de 5 dobras, sempre sobre a base de treino — Dummy, Árvore de Decisão, Random Forest, XGBoost e LightGBM.
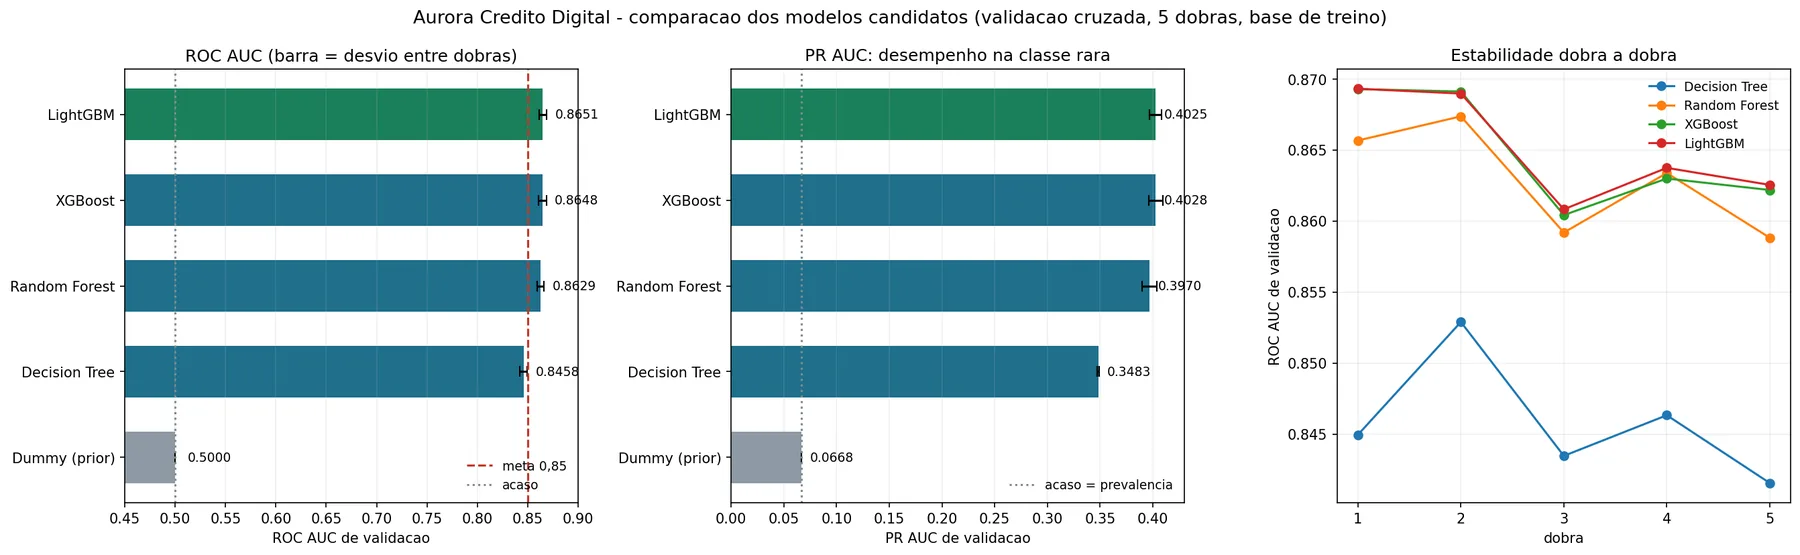
Esse paralelismo é o primeiro sinal, e ele é mais forte do que parece: a variação entre as dobras é maior do que a variação entre os modelos. Traduzindo, nessa altura a partição dos dados explica mais do que a escolha do algoritmo. Se eu tivesse sorteado outro random_state, a ordem do pódio poderia ter invertido.
A prova no conjunto de teste — 37.500 clientes nunca vistos
Aqui vem o número que me fez parar:
| Métrica | XGBoost | LightGBM |
|---|---|---|
| ROC AUC | 0,869250 | 0,869171 |
| PR AUC | 0,409090 | 0,410106 |
| Acurácia | 0,937760 | 0,938373 |
| Brier (calibração) | 0,048514 | 0,048472 |
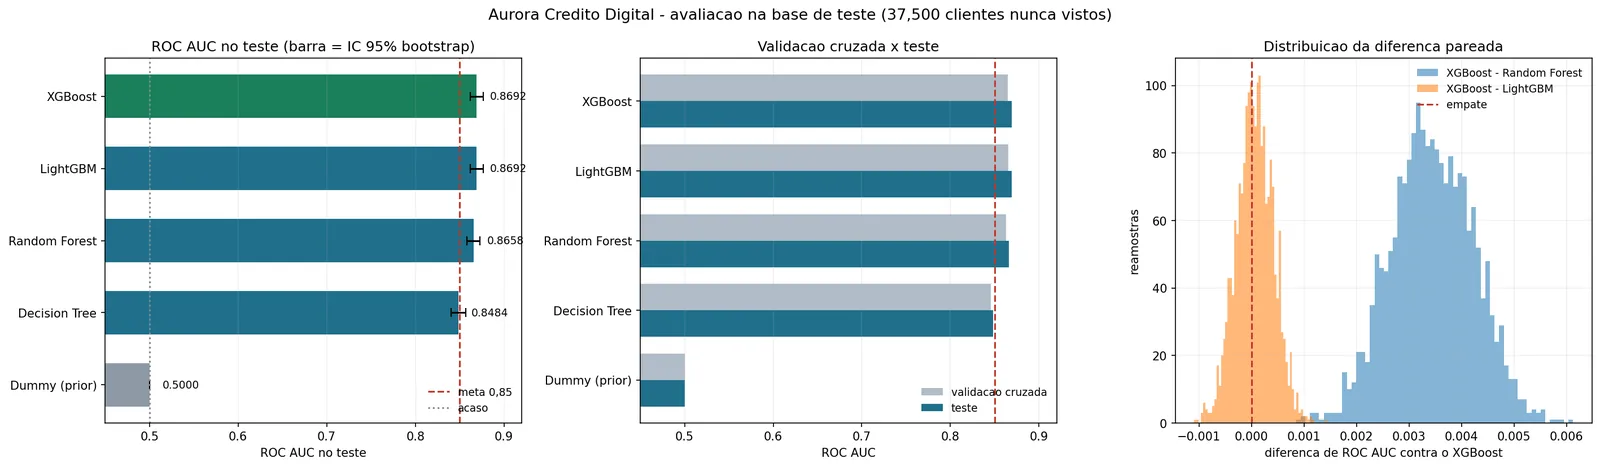
O XGBoost ganha em ROC AUC por 0,000062. Sessenta e dois milionésimos — e perde nas outras três. Só que num conjunto de teste único existe uma leitura por modelo: não há desvio entre dobras para comparar. Por isso o desempate passa por bootstrap pareado — 2.000 reamostragens do teste, as mesmas reamostras para os dois modelos.
| Leitura do bootstrap | Valor |
|---|---|
| Diferença média de ROC AUC | 0,000062 |
| Intervalo de confiança 95% | −0,000625 a 0,000741 |
| Reamostras em que o XGBoost venceu | 56,6% |
O intervalo cruza o zero e o XGBoost venceu em 56,6% das reamostras. Cara ou coroa. Não existe diferença real entre os dois. E a comparação ao lado dá a régua: a vantagem do boosting sobre a floresta tem intervalo que nem encosta no zero — aquela é real. A do XGBoost sobre o LightGBM, não.
Se a curva ROC e o AUC ainda são abstratos, o explicador interativo deixa arrastar o limiar e ver a matriz de confusão se reorganizando. O caminho estatístico completo até aqui está na parte 9 da série.
Se o ROC AUC empata, o desempate vem do dinheiro
Os custos foram definidos pela área de risco, e a assimetria entre eles é o que organiza toda a decisão:
| Erro | O que acontece | Custo |
|---|---|---|
| Falso negativo | aprovamos quem deu calote — perdemos o principal | R$ 5.000 |
| Falso positivo | negamos quem pagaria — perdemos a margem | R$ 500 |
Razão de 10 para 1. E daí sai o limiar teórico, que não depende de nenhum dado:
p* = custo_FP / (custo_FP + custo_FN)
p* = 500 / (500 + 5.000) = 0,0909
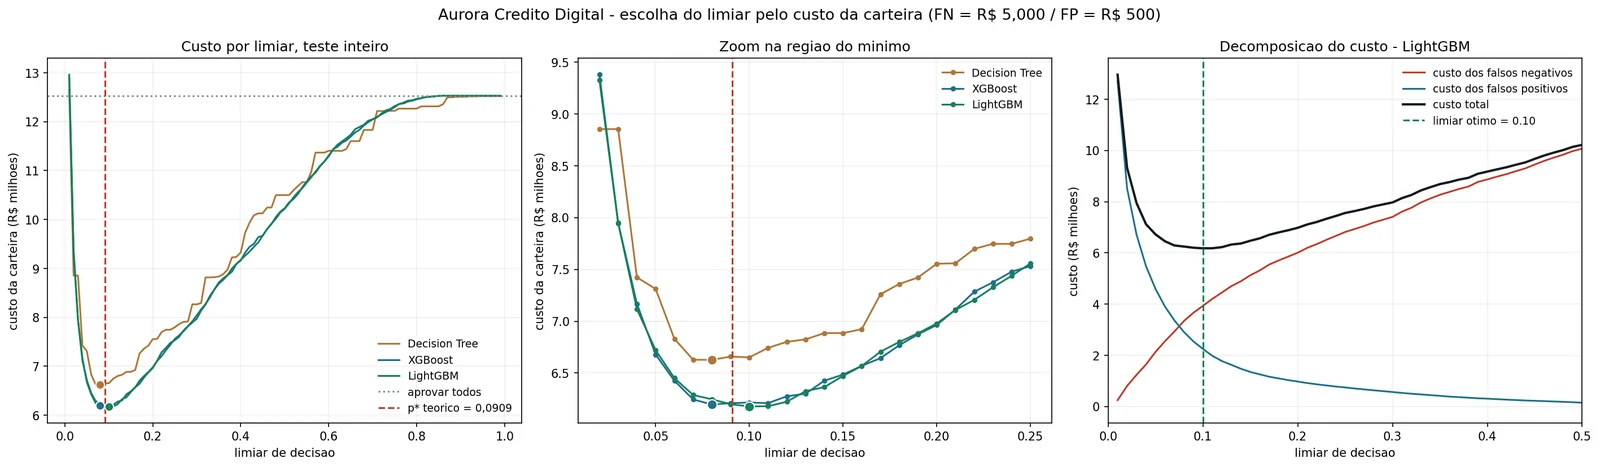
Com o limiar derivado da teoria, varri a faixa de 0,01 em 0,01 nos dois modelos e calculei o custo da carteira em cada ponto:
| Custo da carteira | XGBoost | LightGBM |
|---|---|---|
| No limiar econômico p* = 0,0909 | R$ 6.196.500 | R$ 6.179.000 |
| No limiar 0,50 que vem de fábrica | R$ 10.230.000 | R$ 10.218.500 |
Dois achados aqui, e o segundo é o que eu levaria para qualquer comitê.
O primeiro: o LightGBM custa R$ 17.500 a menos. São 0,3% — pequeno, mas é a única diferença entre os dois que não desaparece no ruído.
O segundo: usar o 0,50 que vem embutido no predict() custaria R$ 4 milhões a mais. Escrito lado a lado, fica constrangedor — a escolha do algoritmo valeu 0,3%; a escolha do limiar valeu 40%.
O painel da direita do gráfico mostra o mecanismo: subir o limiar troca falso positivo por falso negativo. A curva azul cai, a vermelha sobe, e o ótimo é onde a troca deixa de compensar. Como o falso negativo vale 10× mais, isso acontece bem antes da metade da escala — e é por isso que o corte fica perto de 9%, não de 50%.
O mesmo preço, agora contado em pessoas
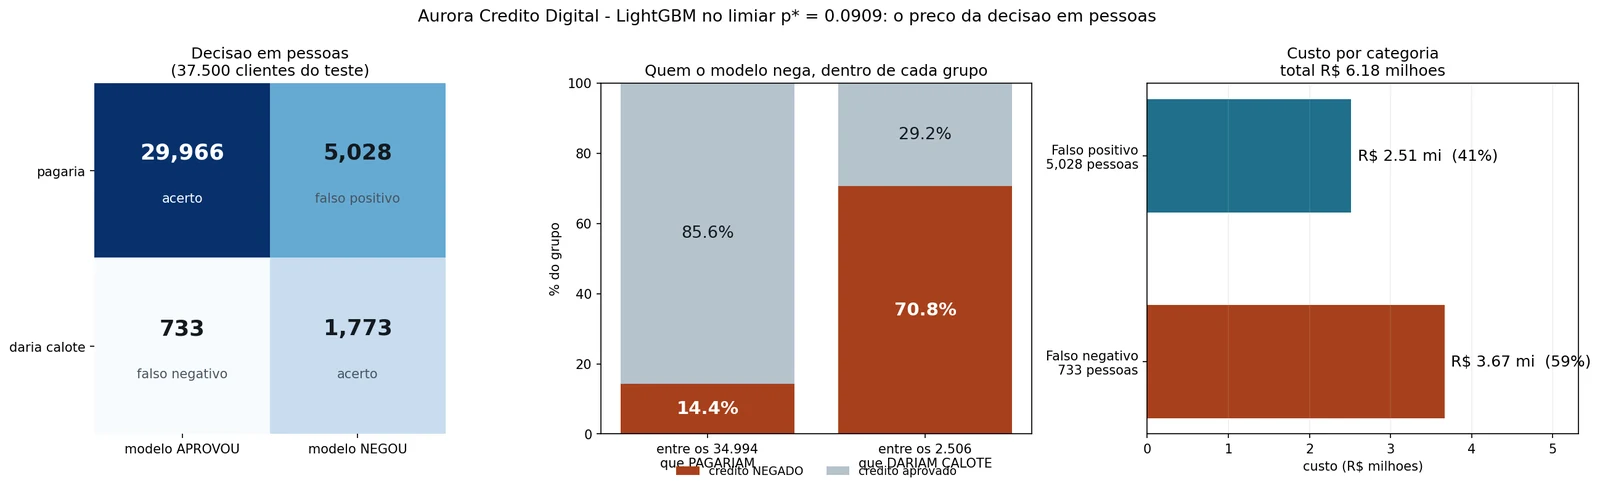
Reais são a linguagem do comitê. Mas cada real dessa conta é uma decisão tomada sobre alguém que pediu crédito, e essa tradução muda o que se enxerga.
| A decisão, em pessoas | % do grupo | Pessoas |
|---|---|---|
| De quem pagaria, teve crédito negado | 14,37% | 5.028 |
| De quem daria calote, teve crédito negado | 70,75% | 1.773 |
| Bons pagadores recusados por cada mau pagador barrado | — | 2,84 |
E o custo, quebrado por categoria de erro:
| Categoria | Pessoas | Custo total | % do custo |
|---|---|---|---|
| Falso negativo | 733 | R$ 3.665.000 | 59,3% |
| Falso positivo | 5.028 | R$ 2.514.000 | 40,7% |
Vale reler a tabela devagar: 733 pessoas geram quase 60% do custo; 5.028 pessoas geram os outros 40%. O erro raro é o caro. É essa inversão que empurra o limiar ótimo para 9% — a política aceita errar com muita gente barata para não errar com pouca gente cara.
O desempate final, em uma frase
Mesmo limiar, mesmos 37.500 clientes, os dois modelos lado a lado:
| No limiar p* = 0,0909 | Bons pagadores recusados | Caloteiros barrados |
|---|---|---|
| XGBoost | 5.053 | 1.772 |
| LightGBM | 5.028 | 1.773 |
O LightGBM barra um caloteiro a mais e recusa 25 bons pagadores a menos. Vinte e cinco pessoas que pagariam e que, com o outro modelo, ouviriam não.
É por isso que escolhi o LightGBM. Não porque o ROC AUC é melhor — ele não é. É porque, quando o critério principal empata, quem decide são os secundários: calibração, PR AUC e, principalmente, quem fica de fora.
Escolher pela terceira casa decimal de uma métrica cujo intervalo de confiança cruza o zero é falsa precisão. Escolha pelo que não é ruído: custo da carteira, calibração, custo de manutenção, latência, interpretabilidade.
A lição que fica
Passei o projeto inteiro perseguindo ROC AUC. No fim, a diferença entre o melhor e o segundo melhor modelo foi de 0,3% no custo — enquanto podar a árvore de decisão valeu +0,231 de ROC AUC e escolher o limiar certo valeu R$ 4 milhões.
A conclusão é desconfortável para quem gosta de comparar algoritmos: a escolha do algoritmo é a decisão menos importante de um projeto de crédito. Os dados, o tratamento e o limiar importam muito mais. E o empate, longe de ser um problema, foi o que obrigou o projeto a olhar para o lugar certo.
Epílogo da série Aurora — um modelo de risco de crédito do zero ao deploy. Este texto fecha a curva de custo e o corte recomendado que a parte 11 deixou em aberto. O mapa completo da série reúne as doze partes; veja também a documentação técnica e o código no GitHub ↗.